
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
摘要:
沙丘智库《AI技术跟踪月报》面向AI从业者,持续观察以大模型为核心的AI技术发展。报告从论文、开源工程、模型发布及产品与服务四类公开活动中,分析研究方向、工程实现和应用进展,并通过技术雷达呈现值得关注的技术路线及其成熟阶段。2026年8月收录1,659篇论文、169项开源工程事件、57项模型发布与重要更新,以及257项产品与服务事件。
01
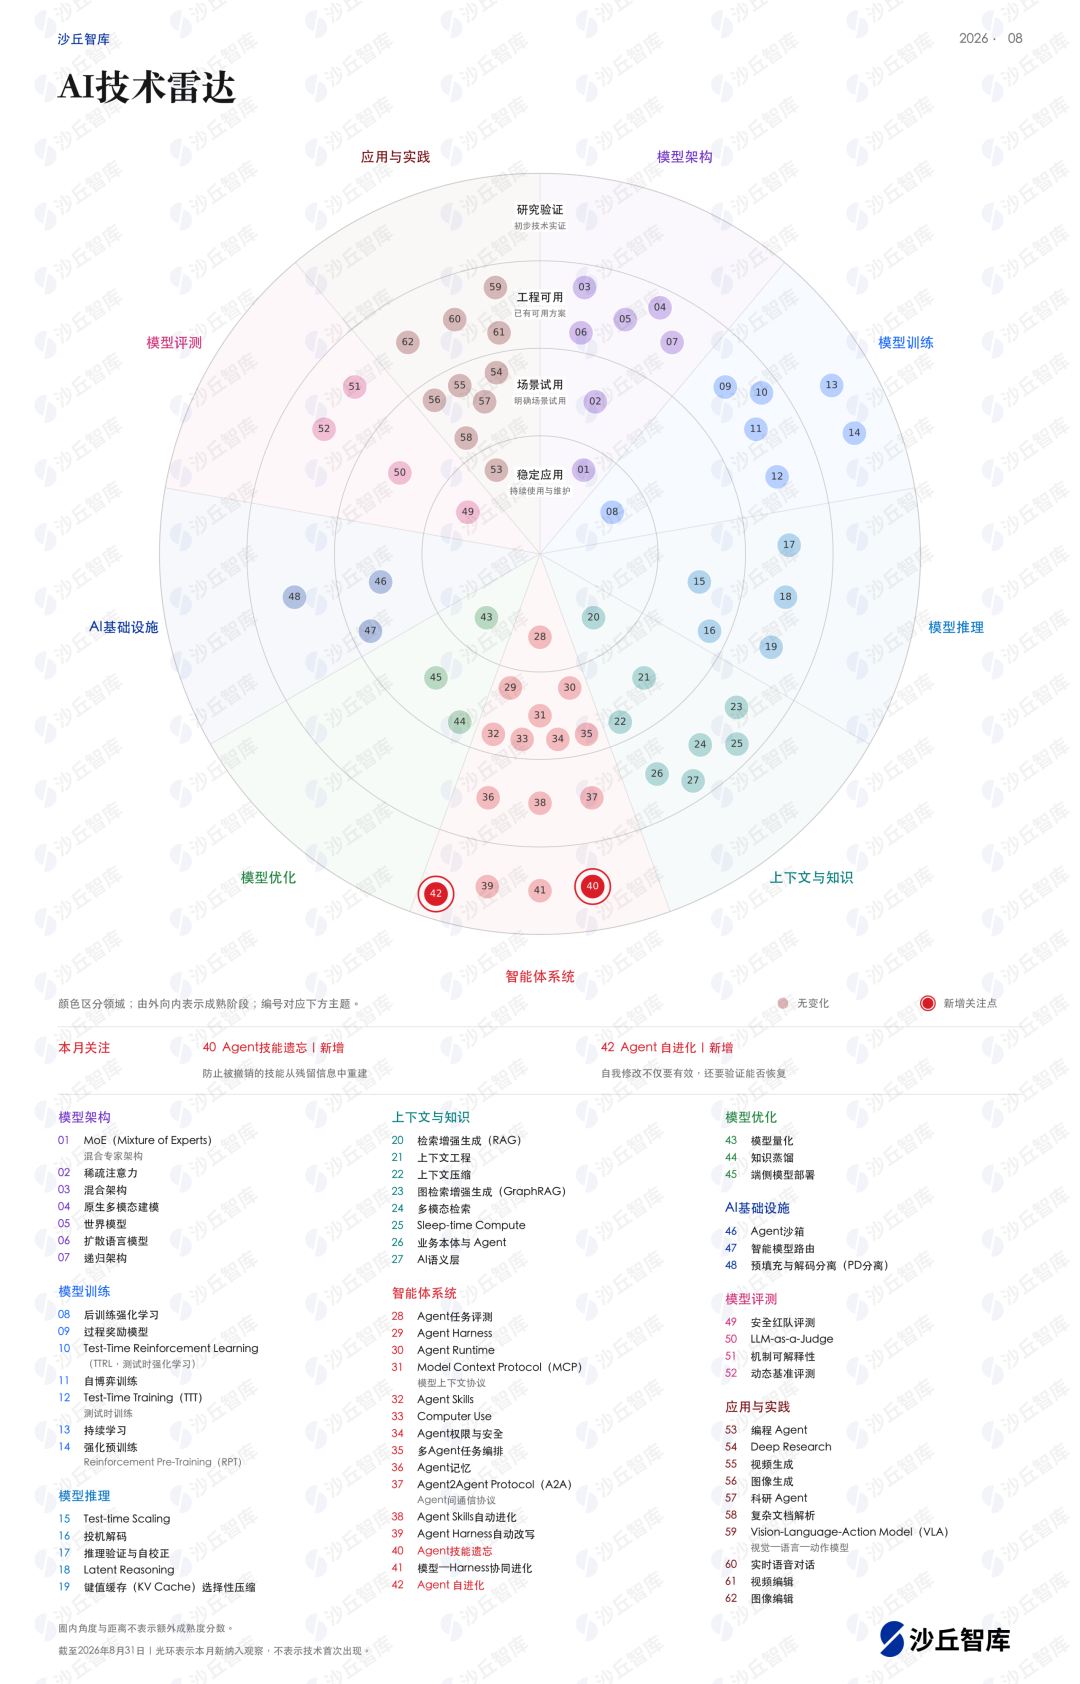
AI技术雷达:本月新增两项Agent技术
AI技术雷达本月新纳入Agent自进化与Agent技能遗忘两项AI技术,均处于研究验证阶段。Agent自进化关注系统如何根据任务反馈改进策略、工具与执行流程,Agent技能遗忘关注已移除的操作能力是否仍可能通过残留记忆、文件或工具恢复。
02
本月核心判断
1. Agent Harness正在成为连接模型训练与应用交付的基础
Agent Harness是围绕模型组织上下文、工具和执行步骤的框架。它决定模型接触哪些信息、能够采取哪些动作,也决定失败之后任务如何继续。Agent Lightning与Lego-RL将实际使用的框架接入强化学习训练;腾讯云ClawPro适配DeepSeek Harness;LangChain为开源Deep Agents提供托管运行服务。Meta也将Muse Spark 1.2与编程工具Muse Code联合训练。框架由此同时参与能力训练和产品交付。
这些案例展示了框架参与训练、被第三方适配和提供托管服务的具体路径。研究分布提供了相应背景:本月Harness占Agent论文的16.4%,高于上月的12.3%,围绕执行框架的研究份额扩大。对采用方,模型选型、执行流程设计和训练环境需要作为关联决策考虑;遇到失败时,也应分别检查模型能力、信息输入和工具流程,确定优化对象。
2. 评测的关键问题,是能否衡量真实工作
本月模型评测论文中,基准与评测资源的占比由24.0%提高至32.2%,测试资源是明显的增长方向。资源增加之后,更值得检验的是测试怎样对应实际使用。AgentStream观察经验复用是否改善后续任务,AgentSLABench将资源预算纳入任务评价,LangSmith则把专用评价器接入运行记录。三者分别把检查延伸到连续工作、资源约束和使用后的错误定位,为团队补充实际任务测试提供了具体方法。
一次答对、持续工作可靠、在限定资源内完成任务,是不同的能力。AgentStream中部分组合的经验复用出现负收益,尤其说明“记住更多”不必然带来“做得更好”。新测试集与更高榜单分数仍有价值,但产品判断还需要知道测试是否覆盖实际工作、失败发生在哪里,以及质量提升付出了什么成本。评测不能只在模型发布时出现,也需要进入系统开发与迭代。
3. 专业软件不必成为任务入口,也能参与Agent交付
Replit允许外部助手创建、修改与发布应用,Salesforce开放面向Agent的业务操作,进一步展示了用户入口与专业执行软件分离的方式。此前,阿里云PAI已经开放诊断和开发操作,Elicit也把检索、报告与系统综述提供给外部工作流程。从开发平台到研究服务和企业软件,已有多种产品采用这种交付路径。
这些产品提供的不只是资料,而是能够产生工作结果的操作。Agent负责理解目标与组织步骤,专业软件继续执行数据、权限和业务规则。软件的价值因此既可以来自直接使用,也可以来自被其他Agent可靠调用;“能否接入”之外,更重要的是开放了什么操作、执行结果如何检查。
4. 模型效率取决于整项任务的配置,而不只是参数量
本月值得关注的效率进展涉及两项具体配置:模型发布提供配套加速组件,产品在执行任务时选择模型与思考强度。Meta为Muse Glimmer配套量化权重和草稿模型(Draft Model:先快速预测几个Token,再由目标模型批量验证,以加快生成的辅助模型),Liquid AI与InclusionAI提供不同用途的型号与草稿模型;Kimi Code的实验性模型池和Replit自动路由,则让一次工作可以使用不同模型和计算配置。这些更新扩大了团队可以实际测试的优化选项。
选型之后,实现条件还会影响收益。DSpark在不同模型、框架和设备组合中的解码加速差异明显,说明同一种方法不能脱离运行环境评价。因而,效率应落到完成同一任务所需的质量、时间与费用;模型体积、激活参数和生成速度是影响因素,不能直接替代最终工作效果。
03
AI技术活动全景
本月收录论文1,659篇,较上月增加539篇、增长48.1%;开源工程事件169项,增加9项、增长5.6%;模型发布与重要更新57项,减少4项、下降6.6%;产品与服务事件257项,增加2项、增长0.8%。论文收录量增长最为突出,工程小幅回升,模型和产品总量与上月相近。
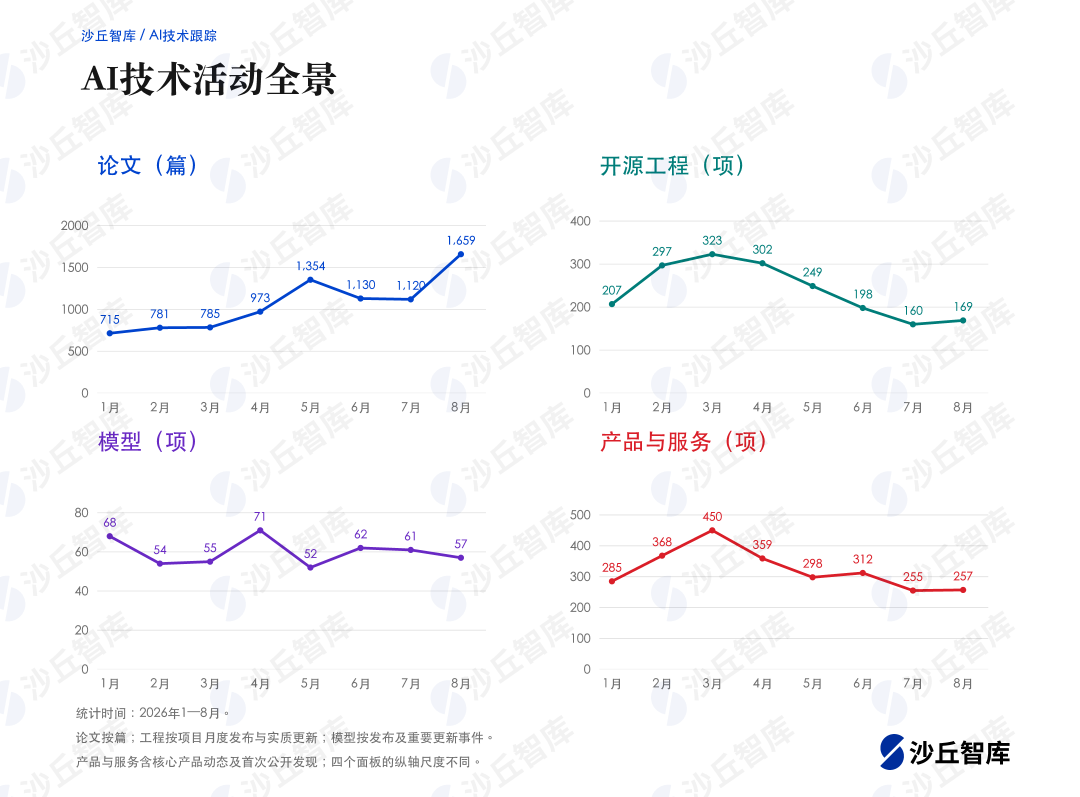
本月论文收录量达到目前所观察月份的最高水平;开源工程数量从3月的323项回落至上月160项,本月出现小幅反弹;产品与服务在此前几个月波动后,数量与上月基本持平。模型发布则一直存在较明显的月度起伏,本月57项仍处在此前的活动范围内。
数量之外,本月值得重视的变化集中在具体工作方式:Agent Lightning与Lego-RL将实际执行框架接入训练,多款产品增加后台执行和操作控制,Muse Glimmer与DSpark等发布提供了模型之外的运行配置,这些更新将会影响研发团队怎样训练、部署和使用系统。
04
四类信号的核心变化
4.1 论文
在本月收录的1,659篇论文中,智能体系统495篇、占29.8%,模型评测453篇、占27.3%,两者合计占57.1%;模型训练200篇、应用与实践170篇,是另外两个较大的领域。如何衡量能力、如何组织模型完成工作,仍然占据研究的重要位置。
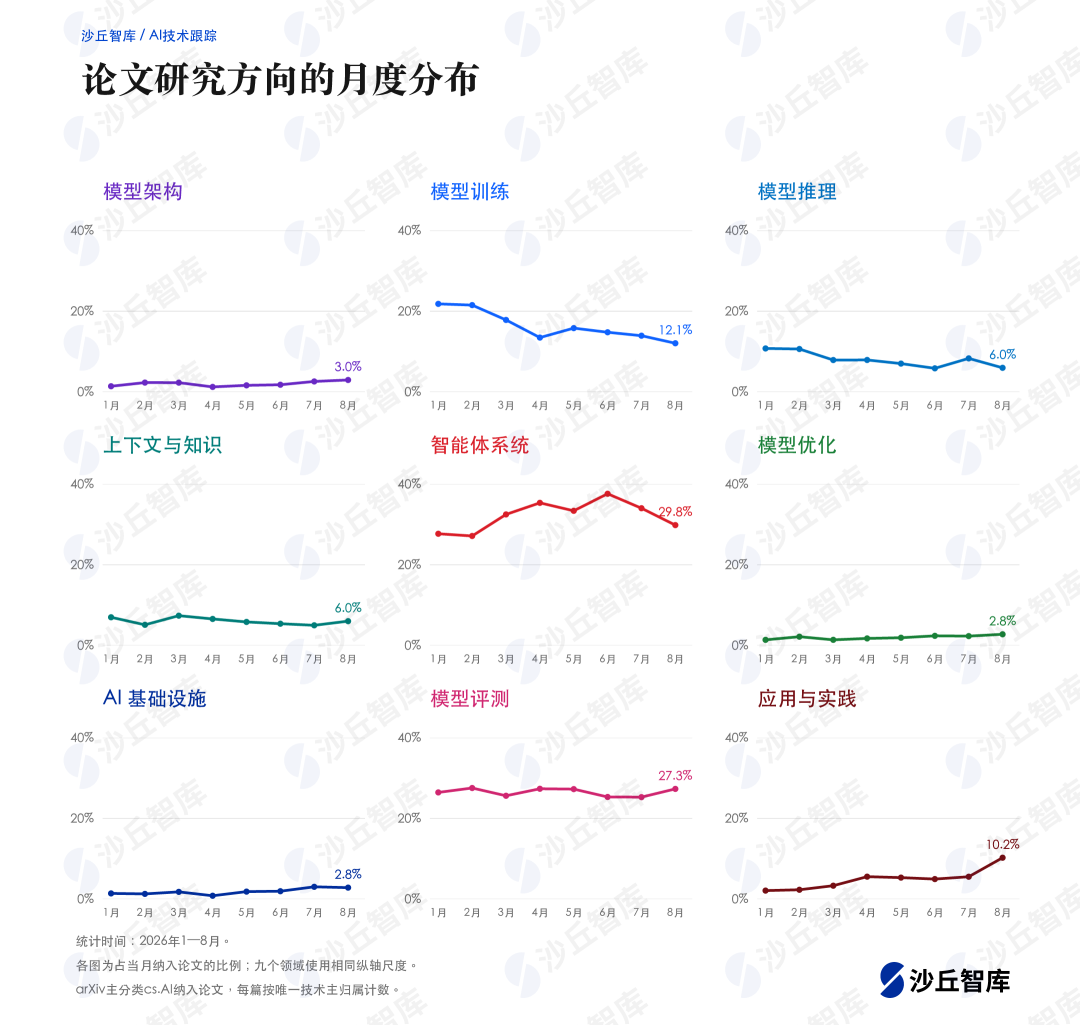
评测与Agent的合计占比较上月59.3%有所降低,但两类论文的绝对量都在增长。Agent由381篇增加至495篇,增长29.9%,占比由34.0%降至29.8%;模型评测由283篇增加至453篇,增长60.1%,占比由25.3%提高至27.3%。
更明显的结构增量来自应用与实践:由上月62篇增加至170篇,占比由5.5%提高至10.2%。这些研究涉及科学计算、研究辅助和专业问题求解,强调把模型能力连接到具体任务并检验结果。它们增加了研究问题的场景广度,但仍需逐项区分方法适配、工作流验证与真正的新能力,不能把所有专业场景论文都理解为自主Agent已经成熟。
4.2 开源工程
本月169项开源工程事件中,智能体系统78项,占46.2%;AI基础设施26项、上下文与知识17项。三者合计121项、占71.6%,分别承担任务组织、运行服务和信息准备等工作。
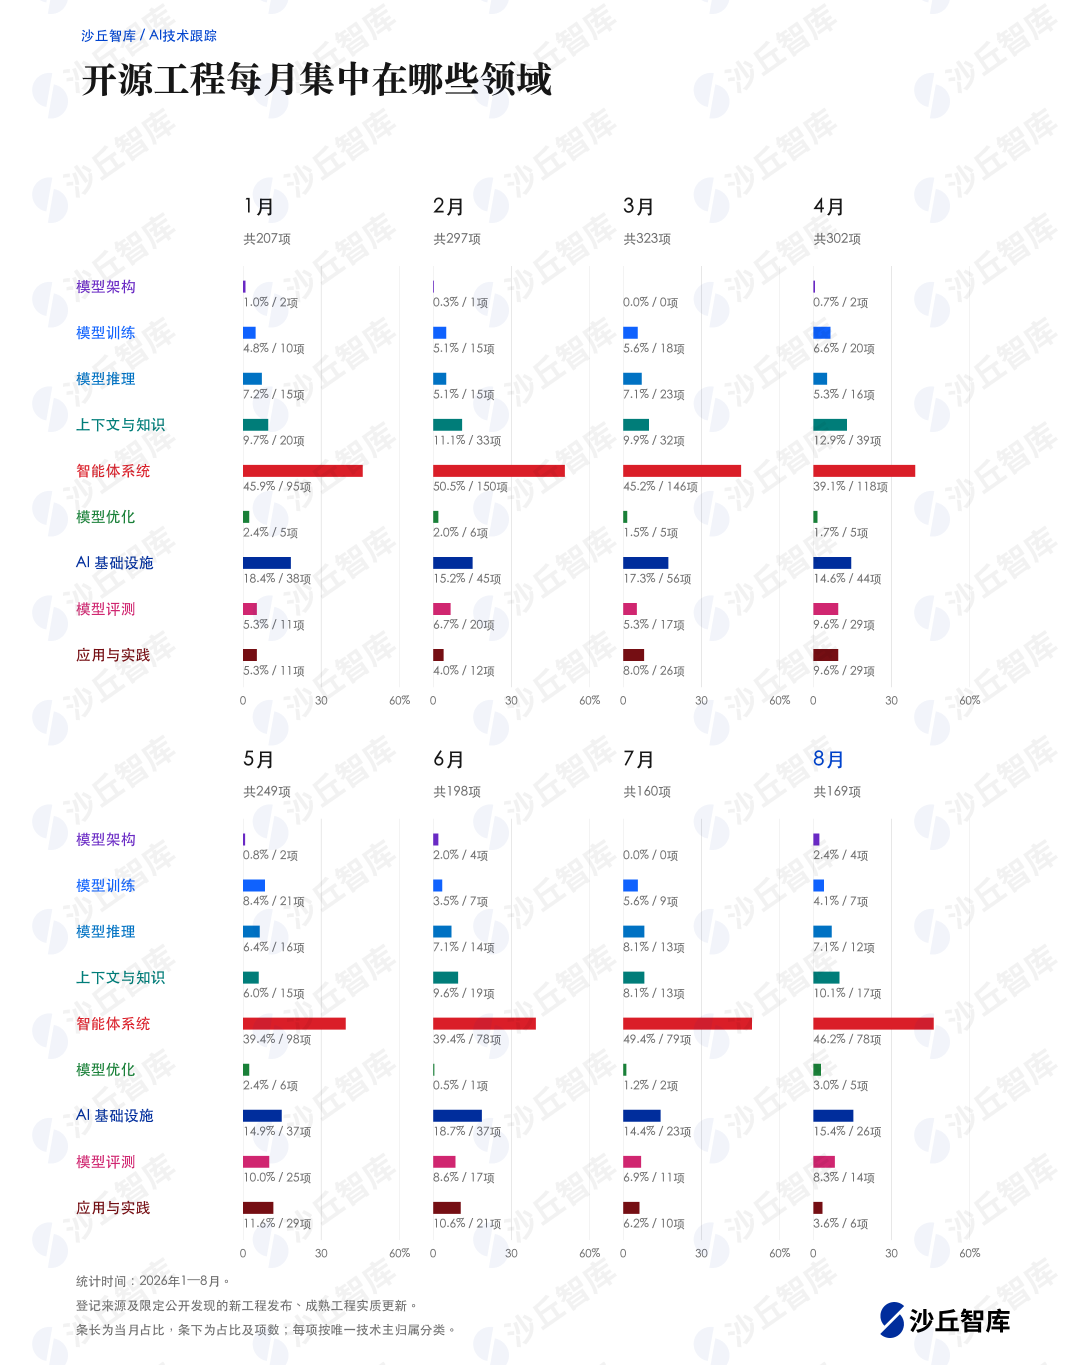
Agent在连续记录中一直居一级领域首位,但数量与占比并非持续增长:本月78项与上月79项接近,占比由49.4%降至46.2%。整体工程数量的小幅回升并非由Agent数量扩张主导,基础设施、上下文与知识等配套领域也贡献了增量。
这种稳定的领先位置说明,模型能够生成回答之后,开发者仍需持续为它配置工具、状态、数据和运行方式。对选型团队,已有项目的实质更新与新项目同样值得看。本月169项中,143项为新工程发布,26项为成熟工程更新;后者更适合用于观察既有开发栈新增了哪些能力。
4.3 模型
本月记录57项模型动态,涵盖新模型、主要版本及重要更新,同批关联变体合并计数。固定观察的20家核心大模型厂商中,14家有相关事件,合计36项;其余21项来自其他模型厂商和研究团队。
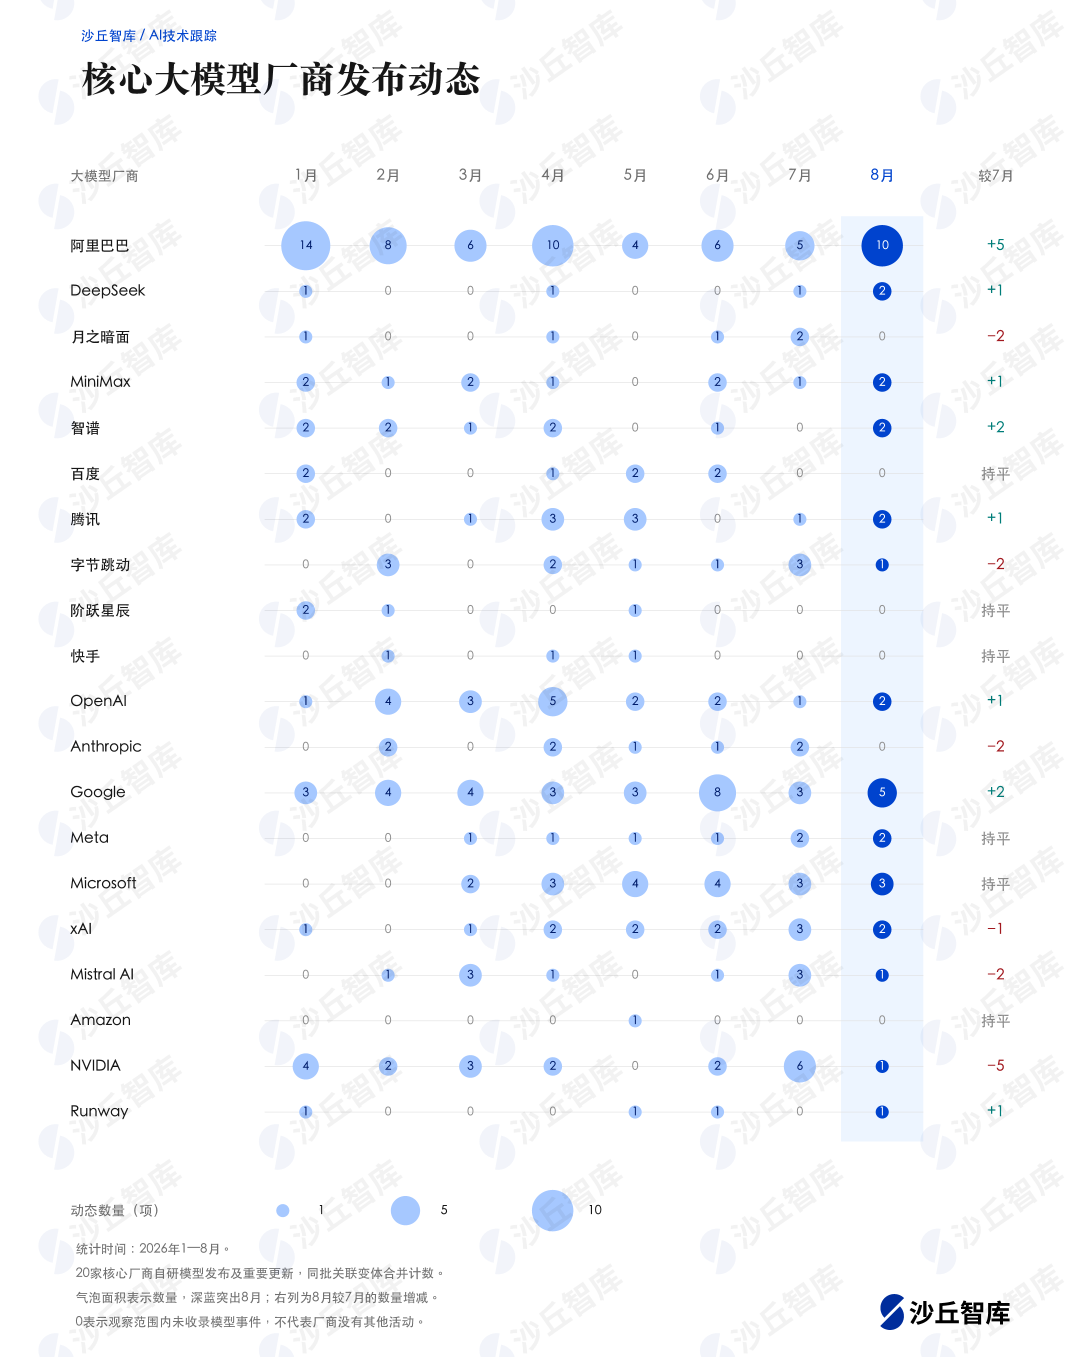
阿里巴巴本月10项,高于上月5项,其活跃度来自多个自研模型系列共同推进,涉及Qwen通用型号、实时音频、文本嵌入、Wan视频、图像翻译,以及既有型号首次开放权重等不同更新。
其他核心厂商的节奏有所分化:Google由3项增加至5项,NVIDIA由6项降至1项;Microsoft维持3项,Meta维持2项。阿里巴巴与Google合计15项,占20家核心厂商本月36项事件的41.7%,是图中本月较活跃的两家。数量展示发布节奏,具体影响仍要看更新涉及的模型用途、能力及开放条件。
Microsoft除代码和图像模型更新外,还推出MAI-Thinking-1公开预览;Meta发布Muse Spark 1.2与Muse Glimmer,分别面向编程执行及本地运行条件。
4.4 产品与服务
本月257项产品与服务事件涉及246组产品,同一产品的关联版本归为一组。专业应用80项、开发平台与服务78项、企业软件与服务70项,合计228项,占88.7%;个人应用24项、智能硬件与机器人5项。
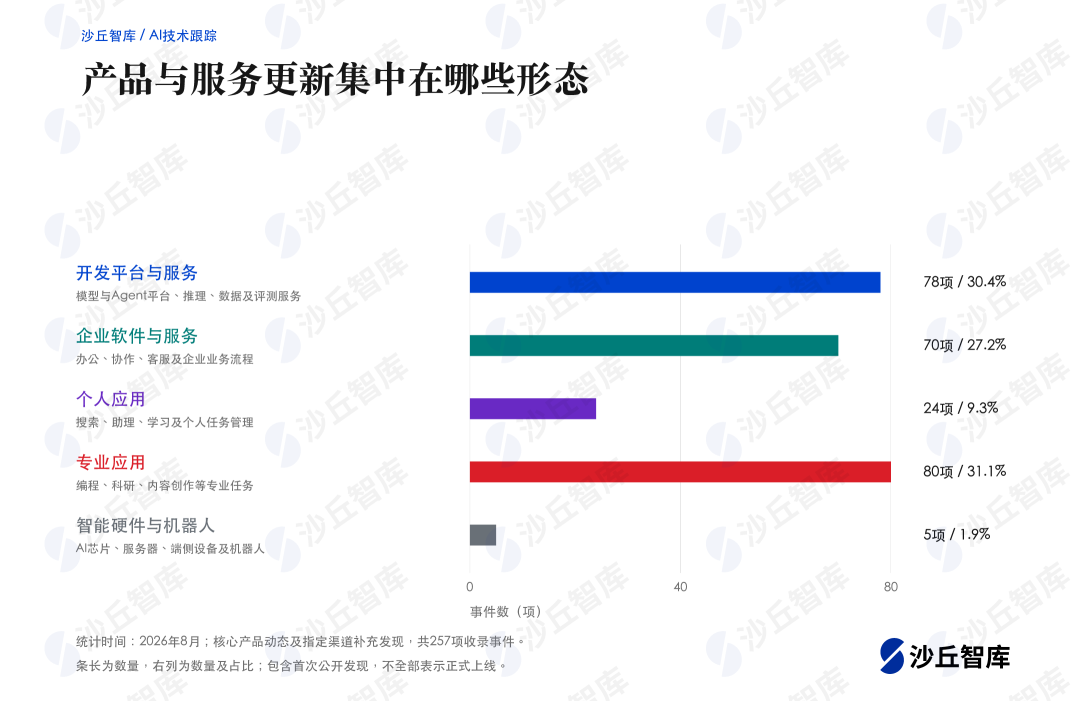
专业应用围绕编程、研究和创作等任务提供直接工具;开发平台承担构建、部署及运行;企业软件把AI接入业务数据和组织流程。三类产品对应不同使用对象,也决定了更新应当怎样评价:直接工具看工作效果,平台看开发与运维能力,企业软件还需要看权限和业务操作。
按主要贡献归入应用场景的事件中,办公39项、编程26项、内容创作26项。它们并非所有具有办公、编程或创作功能产品的总数,但能展示一组明确的工作需求:文件、代码、素材和任务要求进入系统之后,结果还要能够检查、编辑或发布。围绕这些后续步骤组织能力,是本月多项更新的重点。
资料来源:节选自沙丘智库《AI技术跟踪月报|2026年8月》
更多AI研究内容可前往【沙丘智库小程序】搜索查阅