
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
9月16日,豆包2.1 Pro更新了0915版本,专业Agent任务交付是这次升级的重点之一。同一天,搭载豆包手机助手的努比亚新机上市。豆包正在进入更多需要实际操作的场景。
我们用SQBench测试了0915新版,共220项任务,累计运行24.6小时,包含并行执行,再与网站此前旧版Pro的评测记录逐项对照。
比较的两款模型分别是Doubao Seed 2.1 Pro-260628与Doubao Seed 2.1 Pro-260915,均为High推理档位,下文简称旧版Pro和0915新版。
结果是,综合实战得分从48.14降至42.20,且整套任务的记录费用增加了约20%。
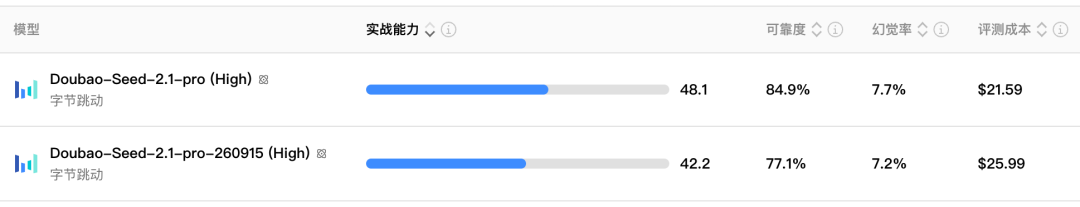
图:SQBench原页面截图。
主要的退步出现在调研、数据处理和软件工程。这些任务要求模型查材料、用工具、处理数据,最后留下可以检查的工作成果。回看执行记录,有的结果做错了,有的工作做到一半,要求的报告却没有交出来。
01
旧模型做对的工作,新模型失手了
支付日志排查是一项很具体的工作:一批交易失败了,需要从网关日志中找出交易编号,再到其他日志里追查原因;已经重试成功的交易,要从最终清单中剔除。
任务还明确要求逐行处理文件,避免一次读入全部内容。
0915新版先查看了网关日志,返回内容里已经列出了几笔失败交易。随后,它用一条命令把目录里的文件逐个输出,连备份文件和大量例行检查日志也一并带了进来。这次工具返回约269万字符,下一次模型请求的输入达到94万tokens。
接下来,它生成并运行了排查脚本。执行结果只有一句:
Wrote 0 record(s)
也就是写入了0条记录。
问题可以在脚本里直接找到。日志中的失败状态写作[STATUS: FAILED],脚本却按[FAILED]去匹配;交易编号周围的括号格式也没有对上。失败交易在最初查看的材料中就存在,到了提取环节却一个也没识别出来。
最终留下的是一个没有记录、文件名也不符合要求的结果文件。旧版Pro在这项任务中拿到100分,0915新版只有22分。
这次排查欠缺的是对输入格式和输出结果的核对。看到日志里有失败交易、脚本却返回零条,至少应该回头检查一次匹配规则。任务记录中没有出现这一步修正。
推荐系统诊断任务则卡在了交付上。
题目给出一个线上故障:推荐模型更新后,离线指标提高,线上点击率反而下降。模型需要检查服务代码、修复延迟问题、运行负载测试,还要提交一份审计报告,解释故障原因和A/B测试设计中的漏洞。
0915新版修改了代码,也通过了规定的负载检查,但要求的审计报告没有生成。接手的人仍然缺少一份完整说明:故障怎样影响了不同用户,离线评估漏掉了什么,线上实验又有哪些干扰。该项成绩从旧版的100分降至40分。
两个案例对应的退步,在整组成绩中也能看到。调研、数据处理、软件工程各有15项任务,完全通过数分别从9项降至5项、10项降至9项、11项降至8项。
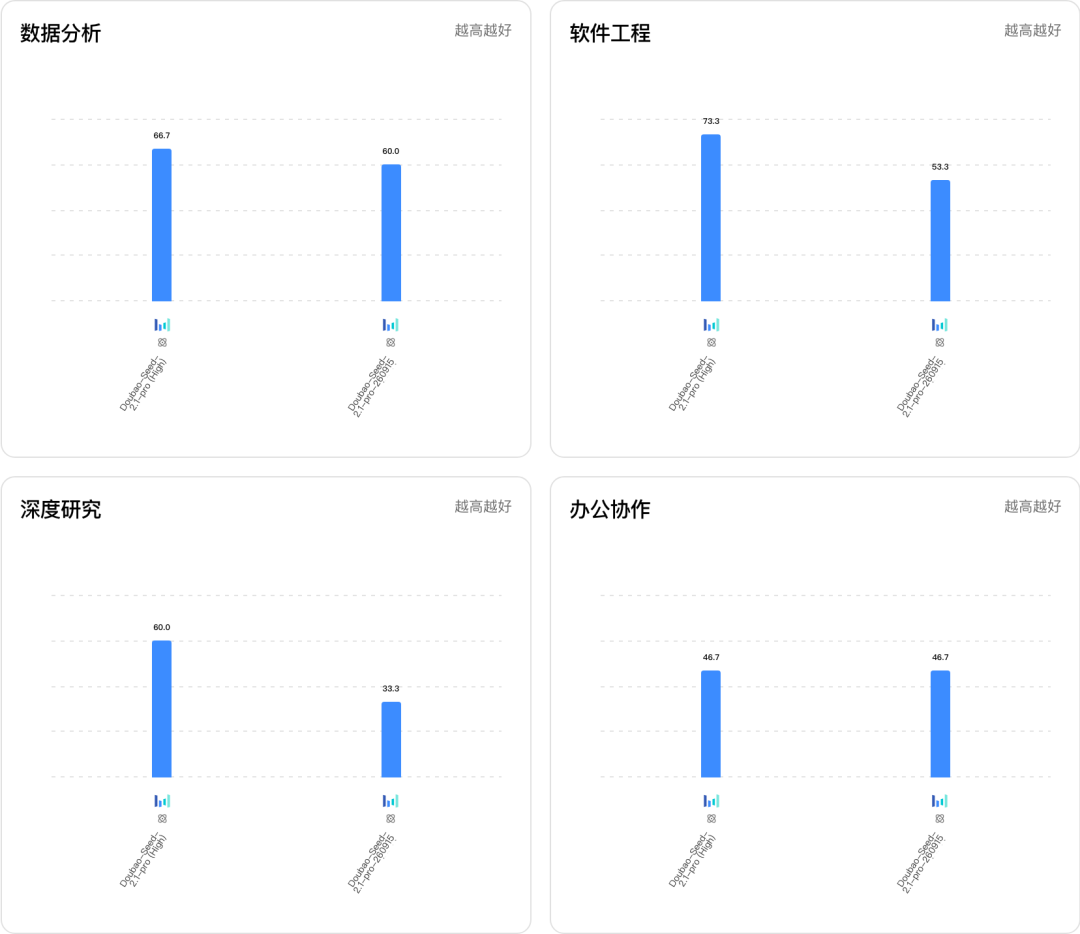
图:SQBench复合技能场景分项截图,显示完整通过率。左侧为旧版Pro,右侧为0915新版。
即使只看得分达到90分的任务,60项复合技能场景中,达到这一水平的也从44项减至34项。
02
花了更多时间和费用,成绩却更低了
做完同一套220项测试,旧版Pro累计耗时19.51小时,0915新版为24.57小时;记录费用从21.59美元增至25.99美元。两轮评测采用的价格快照一致,增加的费用来自实际调用消耗。
额外消耗尤其集中在复合技能场景。这60项任务,新版累计耗时约翻倍,费用增加75.5%,完全通过数却从37项降至29项。
前面的支付日志排查,一次输入就接近百万tokens,最后仍是空结果。不过,更长的等待和更高的费用,也出现在最终通过的任务里。
一项中东局势调研要求梳理历史冲突对油价的影响、核对航运要道的石油流量,并提交带来源的分析报告。两版都拿到100分,旧版任务用时约2分钟,新版约23分钟,费用约为旧版的4.5倍。这是本次任务执行的总用时,包含工具调用和服务等待。
03
智力提升了,执行力却下降了
在原子能力这一层,0915新版的成绩确实提高了。100项任务中,完全通过数从39项增至51项。但在复合技能场景与行业业务场景合计120项任务中,0915新版的通过数从47项减至38项。
SQBench综合实战得分按三个层级的完整通过率计算,原子能力占20%,复合技能场景占60%,行业业务场景占20%。这套权重更看重模型把多项能力组合起来完成工作的表现。新版在原子能力上多拿到的分数,抵不过复合技能场景失去的分数。
部分行业任务也有改善,例如12345热线工单分流,从旧版0分提高到97.66分。行业业务场景整体平均分有所上升,但完全通过数从10项变成9项。部分工作做得更好,与更多工作达到全部验收要求,仍有差别。
这次更新,在SQBench中的综合实战表现退步了,主要失分在复合技能场景。 调研、数据处理和软件工程的成绩低于旧版,整套测试的累计耗时和费用却更高。基础能力的进步,没有补上这些业务任务中的错误和交付缺口。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅