
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
▎摘要
《AI技术跟踪周报》面向AI从业者,通过持续跟踪论文、开源工程、模型及产品与服务,识别和解读本周值得关注的技术变化,帮助读者理解AI技术的演进方向及其对研发与应用的影响。本周(2026年9月7日-9月13日),Agent平台进一步承担跨任务协调与运行管理;记忆研究更具体地揭示了旧信息对当前行动的干扰;训练研究增加了构造可执行环境与自适应任务的方法。与此同时,新实验表明,模型与Harness各自取得的改进不一定能够直接叠加,API成绩也未必代表聊天产品的表现。Agent的开发与使用因此需要同时考虑运行组织、经验有效性、训练条件及实际配置。
01
本周核心变化
1. Agent平台进一步承担跨任务协调与运行管理
此前,编程Agent已支持云端运行、事件触发和代码返工。本周,Cursor Projects将共享上下文和任务委派组织为持续项目;OpenAI通过Agents API提供托管的Codex Harness。部分原本由应用团队自行组织的跨任务协调与运行管理,可以使用平台提供的能力。变化不只是Agent能执行更多任务,也在于谁来保存项目状态、安排后续工作和维护执行流程。
2. Agent记忆的可靠性,还取决于旧信息能否退出当前决策
长期记忆让Agent能够保存经验,但保存、检索和正确使用并不是同一件事。本周研究发现,部分系统中标为失效的记录仍会影响行动;北京航空航天大学与华东师范大学研究者提出的RD-Forget,则保留历史存档并按当前问题筛选可用证据。本周新增的实验与方法进一步说明:记忆可靠性不仅取决于能否找回信息,还取决于事实变化后能否停止使用旧答案。对长期运行的Agent,增加记忆容量不能替代对过期信息的处理。
3. Agent训练进一步把可执行环境和任务生成纳入数据建设
此前的研究已尝试保留实际Agent框架进行训练,本周进一步处理训练任务从哪里来的问题。CUA-Universe组织真实软件的图形界面与命令行环境,EnvCraft合成可交互工作空间,FrogNano根据模型能力生成训练任务。数据建设进一步覆盖环境、任务与结果反馈,而不只是收集静态样本。对研发团队,这增加了构造可反复执行、难度可调整的训练资源的方法。
4. 模型与Harness各自取得的提升,不一定能够直接叠加
此前已知Harness会影响任务结果,本周研究进一步发现:针对弱模型优化Harness后,再模仿强模型的完整轨迹进行微调,反而可能破坏原有适配。另一项研究显示,API评测成绩也不能稳定代表对应聊天界面的表现。模型能力不是脱离使用条件后仍保持不变的结果;更换接口、执行框架或训练方式,可能改变原有优势。两项研究分别从训练适配和访问方式说明了实际配置对结果的影响。
02
AI技术活动全景
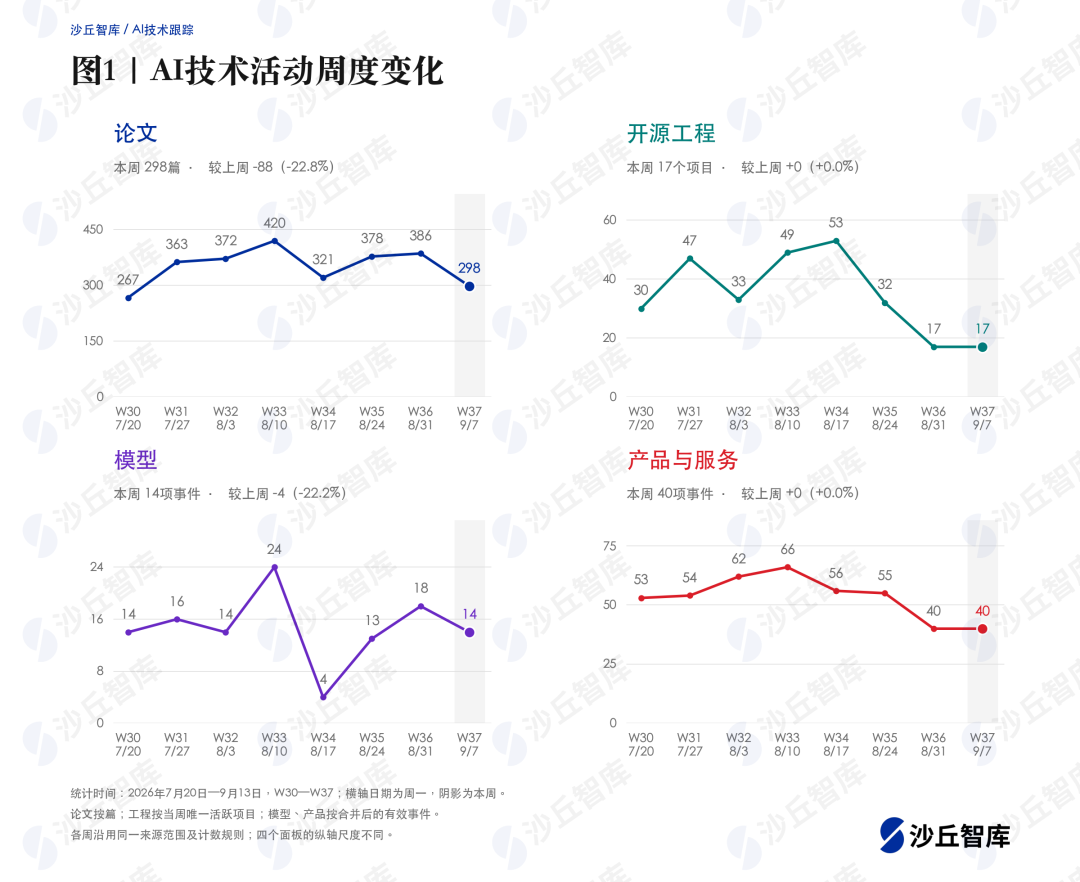
本周收录298篇论文、17个活跃开源工程、14项模型发布与重要更新,以及40项产品与服务事件。论文较上周减少88篇、下降22.8%,模型事件由18项降至14项;开源工程与产品事件数量均与上周持平。最近八周中,论文数量高于W30、低于其后六周,工程与产品活动也处于这一窗口的较低水平。各类总量没有同步增加,但内部方向及更新内容仍在变化。
2.1 论文:Agent与评测继续集中,训练方向数量增加
本周收录论文中,智能体系统101篇、占33.9%,模型评测88篇、占29.5%,两者合计189篇、占63.4%。与上周相比,两类论文数量分别减少17篇和15篇,合计占比却由57.3%升至63.4%。研究结构更加集中于Agent与评测,但这一周的占比上升并不对应论文数量增长。
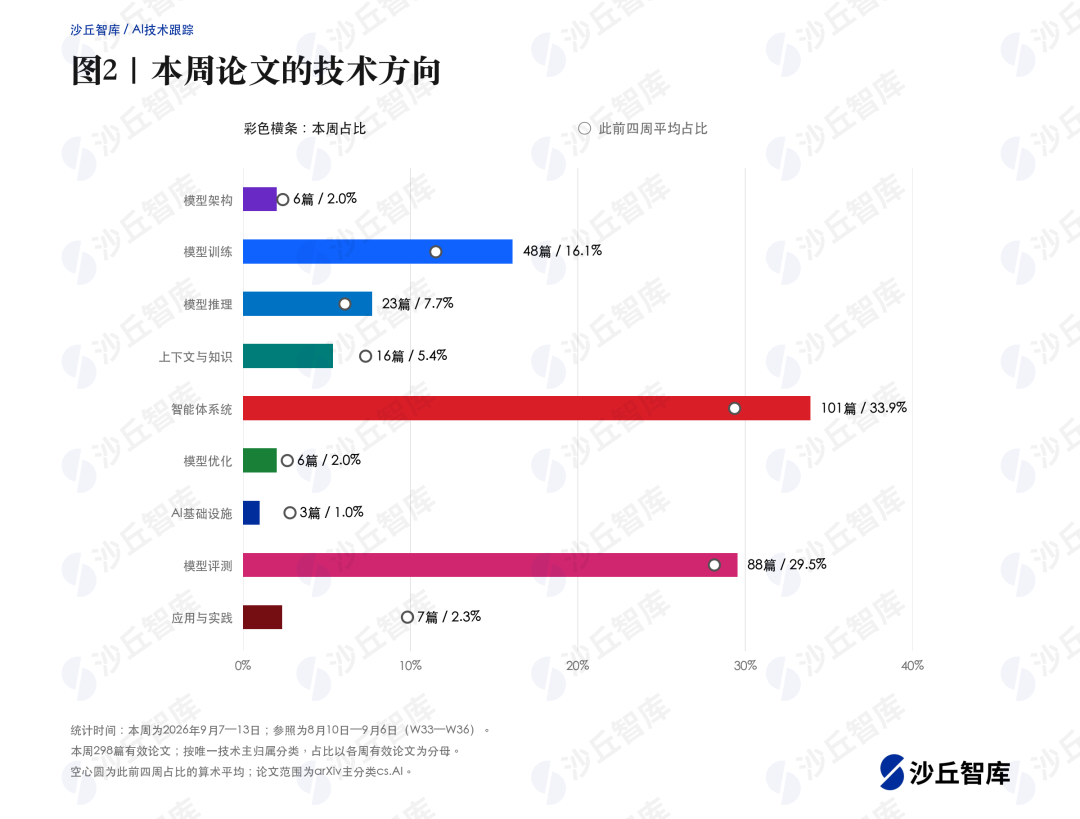
模型训练是更值得留意的数量变化:由43篇增至48篇,占本周论文的16.1%,高于此前四周平均占比11.5%。其中强化学习16篇,与上周17篇接近;合成数据由7篇增至10篇,预训练由2篇增至5篇。训练方向的增加分布在多个环节。代表研究进一步涉及可执行环境、任务难度与反馈生成,具体方法见第三章。
Agent领域内部,任务评测34篇,Agent架构15篇,Agent记忆与Agent Harness各13篇。任务评测与上周33篇接近;记忆由10篇增至13篇,Harness则由21篇减至13篇。记忆、技能复用及信息更新后的行为,是本周值得进一步阅读的具体问题。
模型评测中,行为与机制分析、评测方法与指标各26篇,基准与评测资源22篇。上下文与知识16篇,占比由上周8.8%回落至5.4%;模型推理23篇,其余方向较少。
2.2 开源工程:项目总量持平,更新方向更分散
17个活跃工程中,智能体系统4个、AI基础设施3个;模型训练、模型推理、应用与实践各2个,模型架构、上下文与知识、模型优化、模型评测各1个。与上周相比,基础设施由8个减至3个,Agent工程维持4个,其他方向的项目合计由5个增至10个。
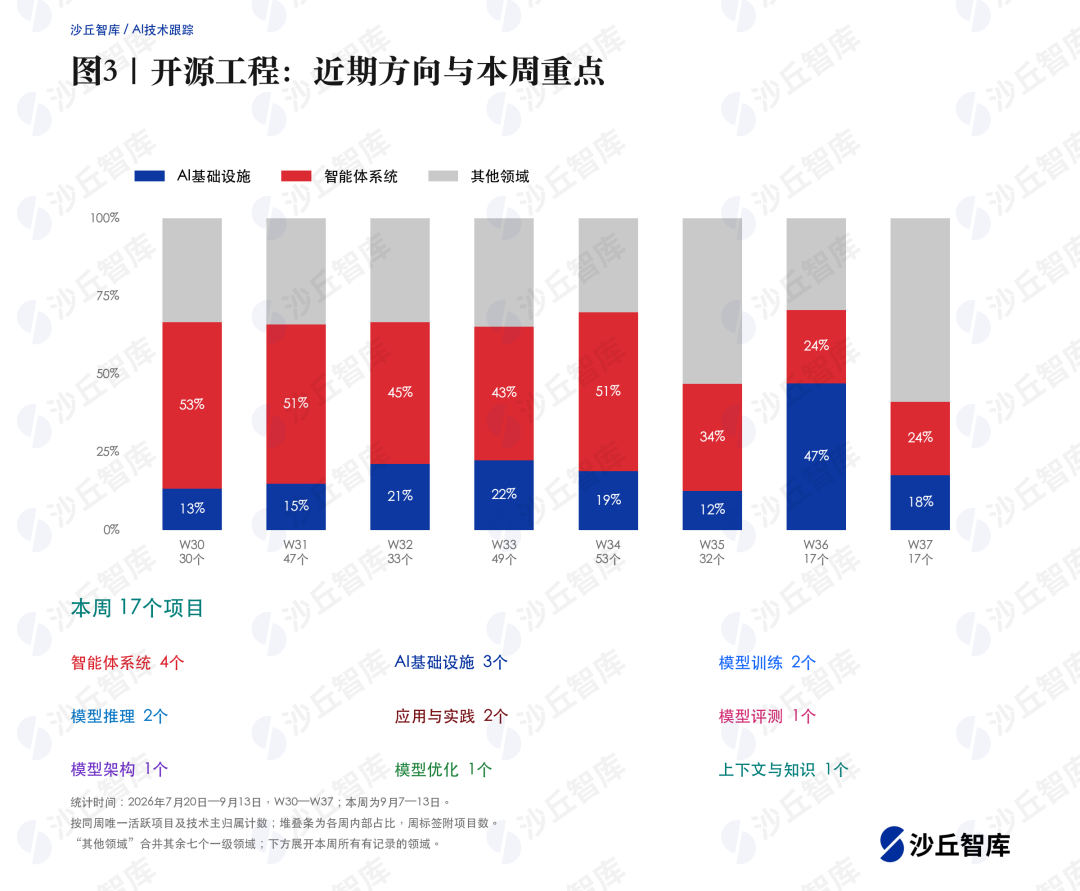
具体更新包括vLLM开源社区的模型执行器、阿里巴巴魔搭团队SWIFT的多模态蒸馏输入、InfiniFlow团队RAGFlow的检索框架,以及Agent记忆和运行管理工具。
2.3 模型与产品:发布数量之外,关注交付方式的变化
14项模型事件来自11家厂商及研究团队。上海AI实验室3项、OpenAI 2项,其余各1项。用途覆盖通用与Agent任务、翻译、科学研究、图像、语音、音乐和专用视频理解。面壁MiniCPM5-2B、腾讯AuK、蚂蚁LLaDA-UI等提供开放权重;GPT-Live-1则把此前产品中的语音能力开放给API开发者。
产品与服务的40项事件涉及33个产品家族。数量与上周相同,更新涉及项目执行、既有服务接入、数据分析、权限管理及创作操作。Anysphere的Cursor Projects和OpenAI的Agents API扩展运行管理;Google Cloud与Replit增加MCP接入方式;BigQuery和OpenAI的Data插件扩展自然语言分析;GitHub则强化企业统一设置的操作权限。这些更新分别改变了不同环节的使用条件。
03
重点变化解读
3.1 从已有的长期任务能力,进一步形成项目级执行方式
此前几周,编程Agent已经可以订阅事件、定时执行、在云端运行,并根据评审反馈继续修复。Cursor在8月已提供事件订阅与长期目标,9月初又增加自托管机器。
Anysphere于9月10日开始推出的Cursor Projects,将这些能力组织为一个持续项目。协调Agent负责规划和委派工作;项目文件在云端与本地执行机器间同步,后续Agent可以复用此前积累的研究、产物和操作说明。云端继续执行,必要时再调用本地Agent测试。工作所依赖的上下文与执行安排,开始更多地围绕项目保存,而不是随每次任务重新建立。该功能目前处于beta。[1]
同日进入公开beta的OpenAI Agents API,把Codex Harness作为托管服务提供给开发者。它提供上下文压缩、工具使用和子Agent协调,并允许选择托管或自有执行环境。应用团队仍需定义业务工具、知识和流程,但可以减少自行维护通用运行框架的工作。[2]
两项进展对应不同用户:Projects面向组织开发任务的人,Agents API面向构建应用的人。它们共同扩大了平台承担的运行管理职责。使用者需要比较的内容也随之增加,包括项目状态如何保留、不同Agent如何共享成果,以及更换模型或框架后,原有任务效果能否延续。
研究侧也在比较长期任务如何组织。康奈尔大学与微软剑桥研究院的《Subagents vs Agent Skills: Executing Reusable Knowledge for Long-Horizon Agentic Tasks》比较把技能说明放入主Agent上下文,与交由独立上下文中的子Agent执行。在技能具备清晰输入输出约定等条件下,后一种方式表现更好,但增加通信开销。[3] 这说明:可复用知识的价值不仅取决于内容,也取决于如何组织和调用。技能说明适合何种执行方式,需要与任务长度及协调成本一起考虑。
3.2 Agent记忆需要控制旧信息的使用,而不只是增加保存容量
持续项目需要经验积累,也会不断遇到信息变化:权限被取消、流程被替换、客户状态被更新。此前能够正确回答的问题,可能因为继续引用旧记录而答错。本周几篇研究把这一问题拆到了检索、行动和历史查询三个层面。
《When Does Memory Help? A Cost-Aware Evaluation of Long-Term Memory in Tool-Using LLM Agents》提出MERIT,评价记忆对实际工具任务的增益及成本。作者观察到,事实更新后,不同记忆实现的表现差异显著;在其报告的相应条件下,正确检索到信息后,Agent按该信息行动的比例仍只有55%。信息进入上下文,不等于它会被正确用于任务。[4]
《Revoked but Still Authoritative: An Empirical Study of Revocation Enforcement in Agent-Memory Systems》则在五套记忆系统、九类策略场景和九个模型中检查失效记录的处理。研究发现,在受测系统的默认设置下,标记为失效的旧规则仍可能被检索,并影响后续行动。作者据此增加位于记忆系统与Agent之间的过滤机制,拦截已失效或与替代记录冲突的信息。[5]
直接删除全部旧信息也有代价:回答“现在应该怎样做”与“上个月为什么这样做”,需要不同的证据。北京航空航天大学的Yuhang Li与华东师范大学的Yuchen Li在《What Should an Agent Forget? Separating What Is Stored from What Is Used》中共同提出RD-Forget,保留历史存档,再根据当前问题组织可使用的记忆。被新事实替代的旧值不应主导当前状态回答,但在历史查询中仍可被调用。[6]
工程侧,微软的amplifier-bundle-memory提供跨会话保存、撤销及记录查看;Hugging Face的ghlore将项目讨论历史与当前代码核对放在一起。[7][8] 这些工程让用户能够查看记忆记录、撤销信息,并核对历史讨论与当前代码的关系。
本周材料让“记忆有用吗”这个问题更具体了:历史可以保留,当前行动所依据的信息则需要随事实变化而更新。对长期运行的Agent,旧规则是否仍会生效、当前答案能否切换到新事实,以及历史查询能否保留原有解释,应作为不同测试项。容量和检索召回率不足以独立回答这些问题。
3.3 训练资源从已有轨迹,进一步扩展到可生成的环境与任务
此前跟踪的Agent Lightning和Lego-RL等工作,关注如何保留实际Agent框架开展强化学习,减少训练和使用过程的差异。本周研究进一步处理与之相邻的限制:即使训练系统接入了真实框架,也需要足够多可以执行、观察状态并检查结果的任务。
上海交通大学与浙江大学研究者提出的《CUA-Universe: A Scalable and Dynamic Environment for Hybrid GUI+CLI Agents》,将16款真实桌面软件组织成可复现环境,同时提供图形界面和命令行操作方式,再合成任务并收集经过验证的执行轨迹。它不仅增加任务数量,也让训练能够覆盖“何时看界面、何时用命令”的选择。[9] 对计算机操作Agent,训练目标因而不必局限于更准确地点选界面,也可以包括选择更合适的操作方式。
哈尔滨工业大学、北京大学、华为与清华大学研究者的《EnvCraft: Synthesizing Executable Environments in Agentic RL for Claw-like Agent》,构造了139个交互环境和约2万个任务。其方法生成沙箱隔离的工作空间及相互一致的任务轨迹,让Agent能够在有状态的环境中学习,而不只是调用互相独立的工具端点。[10]
《FrogNano: Training a 4B Coding Agent via Online Task Synthesis》则围绕约1,500个软件工程环境训练4B编程Agent,并根据当前模型的学习能力在线生成任务。作者报告,其后训练依靠合成任务上的强化学习,不使用传统的强模型轨迹蒸馏。[11] 这里值得关注的是任务难度随模型状态调整。
三项工作分别涉及真实软件适配、可执行工作空间合成和任务难度调整。它们共同增加了一类具体的研发选择:建设训练数据时,同时建设能够持续产生任务与反馈的环境。对多步骤Agent,环境是否可运行、状态是否一致、结果是否可验证,与样本规模同样值得检查。
3.4 优化模型与优化Harness,需要检查两者是否仍然适配
既有研究已经表明,更换Harness会改变Agent结果。本周新增的证据更进一步:即使模型训练和Harness优化分别有用,组合起来也未必获得更好的系统。
Salesforce AI的《Co-Evolving Harnesses and Models: On-Policy Correction Helps Weaker Models Catch Up Where Imitation Fails》先针对较弱模型优化Harness,再用强模型在该Harness中的完整轨迹训练弱模型。受测的两个模型家族在七项企业Agent任务中均出现退步,而相同训练方式在未优化的Harness下可以改善结果。作者分析认为,弱模型模仿了强模型的规划方式,却不具备执行该规划的能力,也偏离了原有Harness所适配的行为。[12]
研究随后改为保留弱模型自身的执行轨迹,只让专家纠正失败步骤,以降低对原有规划方式的扰动。这将“模型与Harness要一起优化”细化为一个更具体的问题:训练改变模型行为后,原来有效的执行框架是否仍然合适?
《What Does Multi-Harness RL Learn? Credit Assignment and Portability in Coding Agents》从另一角度检查迁移:在其固定训练设置中,跨Harness奖励分组没有带来明确的未见Harness迁移收益。[13] 这说明跨框架适配仍需验证,不能仅凭在多个框架上训练就预设能够迁移。
访问方式也会影响比较。斯坦福大学的《API Benchmark Scores Do Not Reliably Transfer to Chatbot Interfaces》在七套系统、九个基准中比较API与聊天界面,报告API平均准确率高出3.4个百分点;调整公开的系统提示、采样和推理设置,也未能稳定消除差异。[14] 这说明API评测不能直接代表对应聊天产品。
因此,本周材料修正的不是“模型能力重要”,而是“模型优势可以不变地带入任何使用方式”这一假设。选型和升级需要检验实际使用的模型、接口与执行配置,不能只叠加各组件独立测得的成绩。
04
重要发布与更新
4.1 大模型厂商:开放权重、专项任务与API能力各有进展
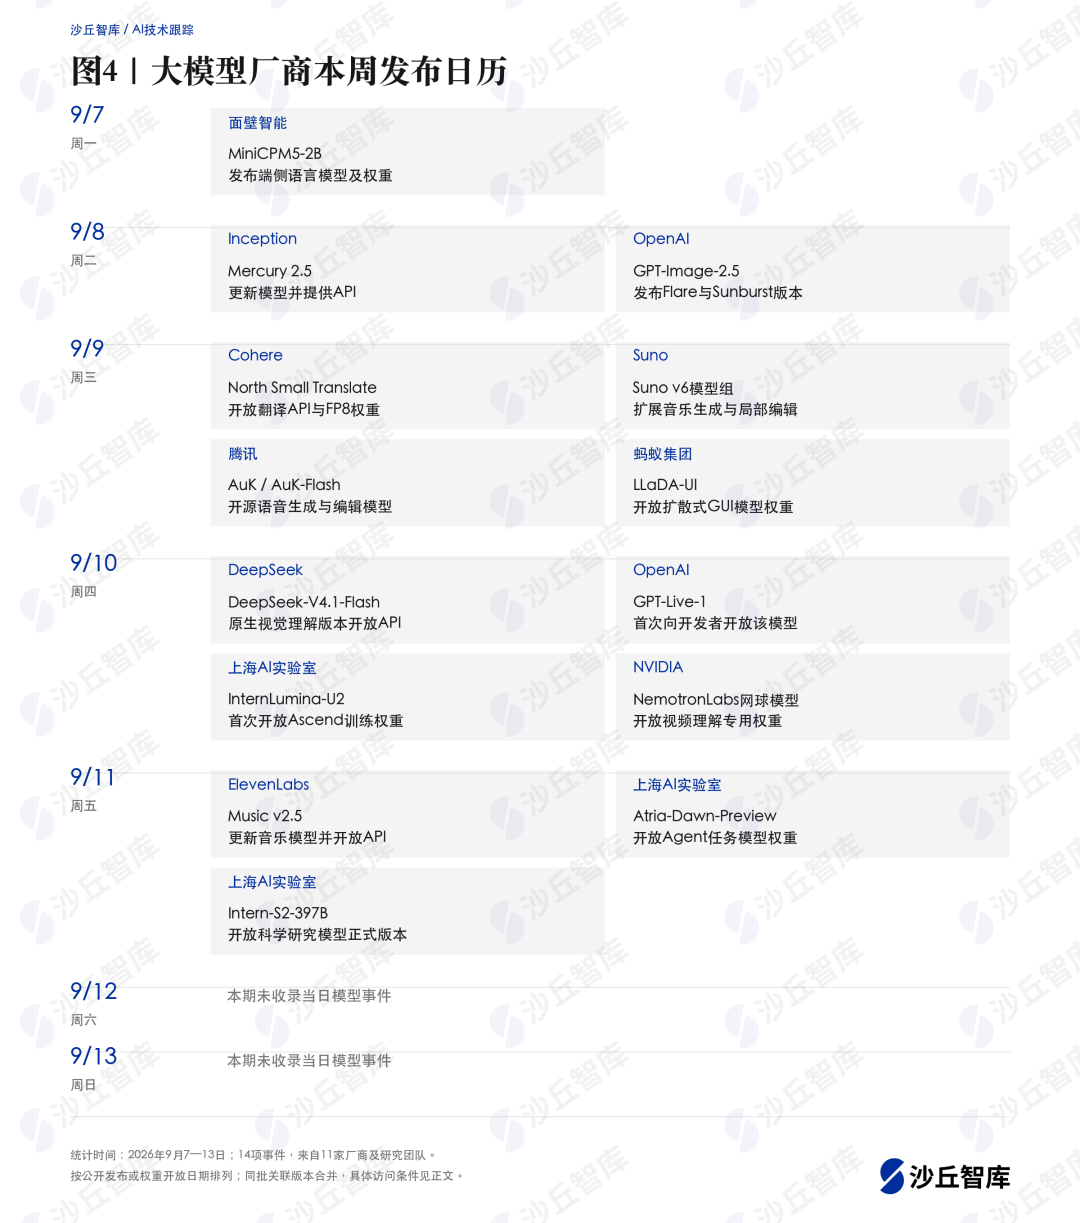
图5补充主要用途与获得方式;发布日历中的事件数已合并同批尺寸、精度及关联版本。
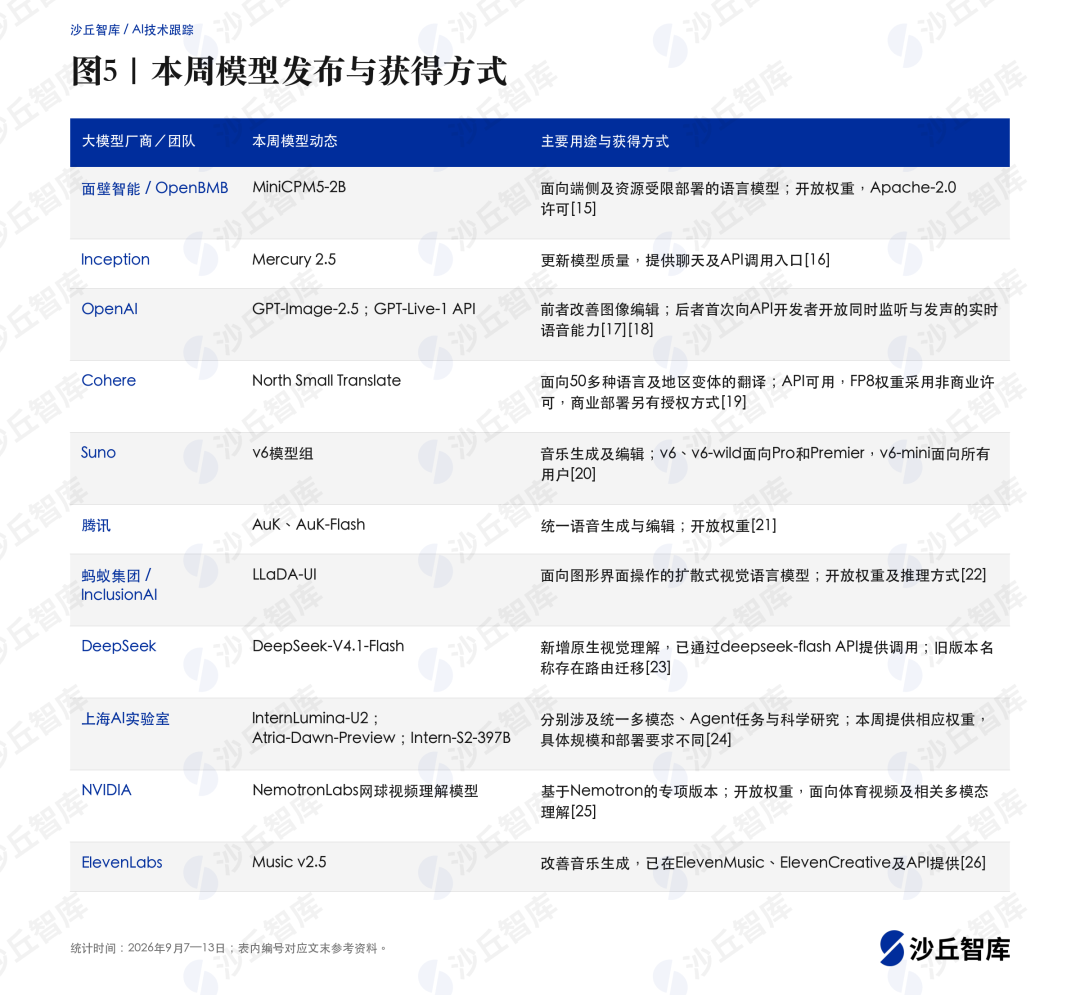
图5参考:面壁智能 / OpenBMB[15];Inception[16];OpenAI[17][18];Cohere[19];Suno[20];腾讯[21];蚂蚁集团 / InclusionAI22;DeepSeek^23;上海AI实验室^24;NVIDIA^25;ElevenLabs[^26]。
MiniCPM5-2B的“2B”名称需要与实际加载规模区分:模型卡列出约2.52B总参数、约1.98B非嵌入参数及131,072 Token上下文。其价值在较小模型的本地部署选择,实际内存仍取决于精度、上下文和运行框架。[15]本文B为十亿参数。
LLaDA-UI则提供另一类观察对象:扩散式模型开始面向图形界面的结构化操作提供专用权重。它与此前的扩散语言、图像模型属于相关路线,但用途与评估要求不同;是否能稳定执行界面任务,需要完整Agent环境验证。^22OpenAI本周通过API开放GPT-Live-1,开发者由此能够把实时语音交互接入自己的应用。[18]
创作模型继续增加具体的编辑选择。OpenAI的GPT-Image-2.5提供Flare与Sunburst两个API版本,强调参考主体保真、局部编辑及多轮修改一致性。腾讯的AuK以1.5B参数统一语音生成与编辑,并开放基础版和四步推理的AuK-Flash权重,为本地适配提供入口。Suno的v6支持用自然语言修改歌词、乐器和混音等细节。[17][21][20] 这些更新分别涉及编辑控制、部署方式和交互操作。
4.2 开源工程:执行器、蒸馏输入和检索框架提供具体改进路径
vLLM 0.29.0:新版执行器成为默认。由vLLM开源社区维护的这一推理服务框架,将Model Runner V2设为默认,并增加CUDA Graph内存分析及分片采样等能力,涉及模型运行和显存使用。部分平台或未支持功能仍沿用旧执行器,升级应按实际部署组合验证。[27]
SWIFT 4.5.3:多模态蒸馏允许教师与学生使用独立视觉输入。阿里巴巴魔搭(ModelScope)团队的训练工具让教师模型与学生模型分别配置视觉输入,扩展了多模态蒸馏的训练方式。蒸馏是让学生模型学习教师行为的方法;这一更新为不同输入条件的训练提供工程支持。[28]
RAGFlow 0.27.2:重构Agentic RAG检索框架。InfiniFlow团队开发的这一开源检索增强框架更新了检索流程,并增加知识编译的运行配置及限流。对已有知识应用,比较重点在检索过程与任务完成效果;版本说明中的性能改善应结合实际语料检验。[29]
Google ADK 2.9.0与MCP Inspector 2.6.0。Google开发的Agent开发工具包ADK增加模型故障转移及声明式工作流加载;由Model Context Protocol开源组织维护的Inspector扩展Skills检查与验证工具。它们分别帮助处理运行中断和接口调试,补足Agent持续运行所需的具体工程环节。[30][31]
4.3 产品与服务:既有服务接入、数据分析与组织管理继续细化
MCP接入:复用既有后端,也扩展跨应用操作。9月11日,Google Cloud API Gateway开始公开预览远程MCP服务,允许开发者通过OpenAPI配置,把已有REST API作为工具提供给Agent,无需修改后端服务。[32] 同日,Replit支持从兼容的桌面MCP客户端创建、检查、更新和发布应用。[33] 两项更新分别改变开发侧和使用侧的接入方式:一方复用已有服务,另一方让用户从原有AI工具中调用外部应用操作,而不只是增加一个“支持MCP”的标签。
业务数据分析:现有分析能力增加自然语言入口。Google BigQuery此前已提供AI.PREDICT函数,本周进一步让对话式分析支持预测建模问题,并增加关联分析支持,均处于预览。[34] OpenAI的Data插件在ChatGPT Work与Codex中支持对连接的业务数据提问、调查变化和生成仪表板或报告,并可使用团队指标定义及业务背景。[35] 新增支持不仅在于连接了哪些数据源,也在于用户能够直接发起哪些分析操作。
企业权限:组织策略进一步约束个人配置。延续上周对文件与操作权限的观察,GitHub于9月9日正式提供Copilot企业统一管理权限:管理员可指定哪些操作被阻止、需要人工审批或可以直接执行,覆盖命令、文件和网络访问,且限制不能被用户设置或自动批准弱化。[36] 本周更具体的增量,是组织能够统一决定这些边界,并让它们在多个执行入口生效。
QoderWake 1.0.3:分享配置与能力。阿里的数字员工产品于9月8日开放Waker分享:通过分享ID,将选定资料和能力导入为新的Waker。[37]
OpenHands:细化自动化任务的管理。这一由All Hands AI团队发起、与开源社区共同建设的编程Agent平台,本周版本增加自动化编辑、运行身份展示及重新启用控制。对反复执行的Agent任务,用户能够更明确地判断由谁配置、以谁的身份运行,以及谁可以重新启动。[38]
即梦AI:整合对话与画布创作。字节跳动旗下即梦AI的新版网页版支持切换对话和画布、管理Agent多会话,并在画布中组织文字、图像、视频和音频任务。相较单项生成入口,这次更新关注多步骤创作如何被安排和继续修改。[39]
ChatGPT Library与Claude Smart reports:分别处理资料协作和使用反馈。OpenAI的ChatGPT Library增加文件夹共享及外部文件源接入,让对话能够继续使用团队资料;Anthropic的Claude Smart reports向Enterprise用户提供beta,分析团队使用、成本和会话阻碍,并识别可整理为共享技能的重复工作。[35][40] 两类功能分别帮助组织输入资料和检查实际使用过程。
05
研究范围与参考资料
统计周期:2026年9月7日至13日(周一至周日)。近期趋势图展示2026年7月20日至9月13日,共八个完整周;论文分布参照为8月10日至9月6日的此前四个完整周平均占比。
本报告通过以下四类公开来源跟踪AI技术进展:
论文: arXiv上以人工智能(cs.AI)为主分类的论文,按首次公告日期统计。 开源工程: GitHub、Gitee的核心项目仓库和版本日志、主要企业与研究机构的官方仓库,以及固定检索补充发现的项目;关注首次公开及实质技术更新,同周同项目合并计数。 模型: 国内外厂商及研究机构的官方公告、模型文档、GitHub与Hugging Face官方发布记录;覆盖新模型、重要版本、能力更新和权重或API开放。 产品与服务: 核心AI厂商、云平台及工具与应用提供方的官方日志、帮助中心和认证发布渠道,结合有界媒体及开放渠道发现;按实际可用的实质事件统计,同一能力的重复说明合并。
[1]: Anysphere / Cursor,更新日志:8月19日Cloud Agents与Harness改进、9月2日自托管机器、9月10日Projects。
[2]: OpenAI,Introducing the Agents API,2026-09-10。
[3]: 康奈尔大学、微软剑桥研究院,Subagents vs Agent Skills: Executing Reusable Knowledge for Long-Horizon Agentic Tasks,arXiv:2609.09233。
[4]: When Does Memory Help? A Cost-Aware Evaluation of Long-Term Memory in Tool-Using LLM Agents,arXiv:2609.05441,MERIT及更新事实实验。
[5]: Revoked but Still Authoritative: An Empirical Study of Revocation Enforcement in Agent-Memory Systems,arXiv:2609.08258。
[6]: Yuhang Li(北京航空航天大学)、Yuchen Li(华东师范大学),What Should an Agent Forget? Separating What Is Stored from What Is Used,arXiv:2609.10263,RD-Forget方法及消融实验。
[8]: Hugging Face,ghlore,项目讨论索引及当前代码核对。
[9]: 上海交通大学、浙江大学,CUA-Universe: A Scalable and Dynamic Environment for Hybrid GUI+CLI Agents,arXiv:2609.05374。
[10]: 哈尔滨工业大学、北京大学、华为、清华大学,EnvCraft: Synthesizing Executable Environments in Agentic RL for Claw-like Agent,arXiv:2609.05576。
[11]: Minseon Kim等,FrogNano: Training a 4B Coding Agent via Online Task Synthesis,arXiv:2609.07925。
[12]: Salesforce AI,Co-Evolving Harnesses and Models: On-Policy Correction Helps Weaker Models Catch Up Where Imitation Fails,arXiv:2609.09134。
[13]: What Does Multi-Harness RL Learn? Credit Assignment and Portability in Coding Agents,arXiv:2609.04518,实验与迁移评估。
[14]: 斯坦福大学,API Benchmark Scores Do Not Reliably Transfer to Chatbot Interfaces,arXiv:2609.08861。
[16]: Inception,Introducing Mercury 2.5,2026-09-08。
[17]: OpenAI,Introducing ChatGPT Images 2.5,2026-09-08。
[18]: OpenAI,Introducing GPT-Live-1 in the API,2026-09-10。
[19]: Cohere,North Small Translate,2026-09-09更新。
[20]: Suno,Introducing v6,2026-09-09。
[21]: Tencent,AuK: An Open-Source Foundational Model for Speech Generation and Editing,2026-09-09。
[26]: ElevenLabs,Music v2.5,2026-09-11。
[28]: 阿里巴巴魔搭(ModelScope)团队,SWIFT v4.5.3。
[29]: InfiniFlow,RAGFlow v0.27.2。
[30]: Google,Agent Development Kit v2.9.0。
[31]: Model Context Protocol开源组织,Inspector 2.6.0。
[32]: Google Cloud,API Gateway远程MCP服务公开预览,2026-09-11。
[34]: Google Cloud,BigQuery对话式预测与关联分析,2026-09-08及09-10;此前AI.PREDICT支持见08-31记录。
[35]: OpenAI,ChatGPT Release Notes,2026-09-09及09-10的Library与Data插件更新。
[36]: GitHub,Enterprise managed permissions for GitHub Copilot agent operations,2026-09-09。
[37]: Qoder,QoderWake 1.0.3,2026-09-08;同页保留1.0.0的此前发布日期。
[38]: OpenHands团队及开源社区,v1.17.0与v1.18.0,2026-09-09及09-11。
[40]: Anthropic,Claude Release Notes,2026-09-10 Smart reports beta。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅