
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
今天凌晨,Anthropic发布了Claude Opus 5.5。这次新模型的卖点相当直接:在大多数工作中达到Claude Fable 5.1的水平,同时让顶尖能力变得更便宜。官方称,默认设置下,Opus 5.5处理典型工作负载的费用比Opus 5低40%,输出速度提升超过30%。
从官方公布的评测看,升级覆盖了编程和知识工作:Terminal-Bench 4.0得分66.4%,GDPval-AA v2.1达到1846 Elo,均高于发布表中的Fable 5.1和Opus 5。Anthropic也提醒,能力达到这一水平后,榜单分差未必能等比例反映实际使用差异。
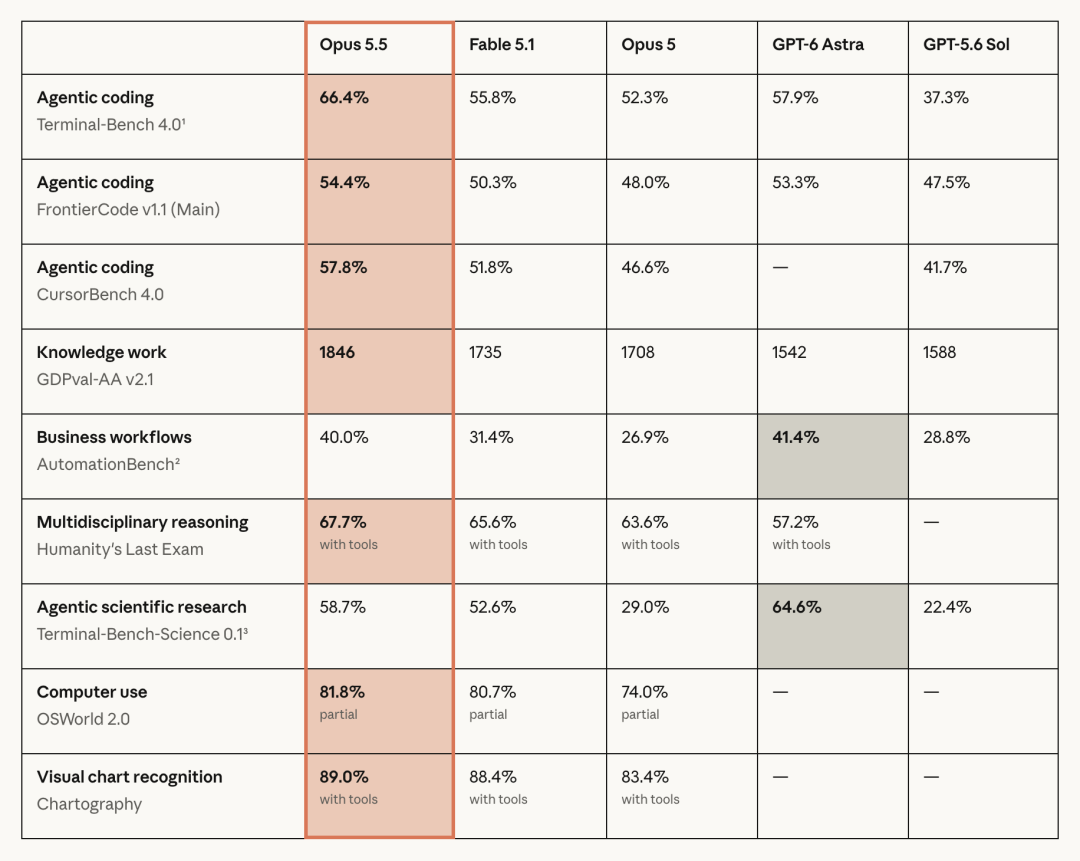
图1:Anthropic官方发布的评测成绩总表。
SQBench刚完成的Claude Opus 5.5实战能力评测,为这次升级补上了另一组实战结果:Claude Opus 5.5(Max)得分65.6,超过GPT-6 Astra的64.3和Claude Fable 5.1的63.1,按当前成绩对照,登顶SQBench。本轮评测成本比Fable 5.1少了约三分之一。
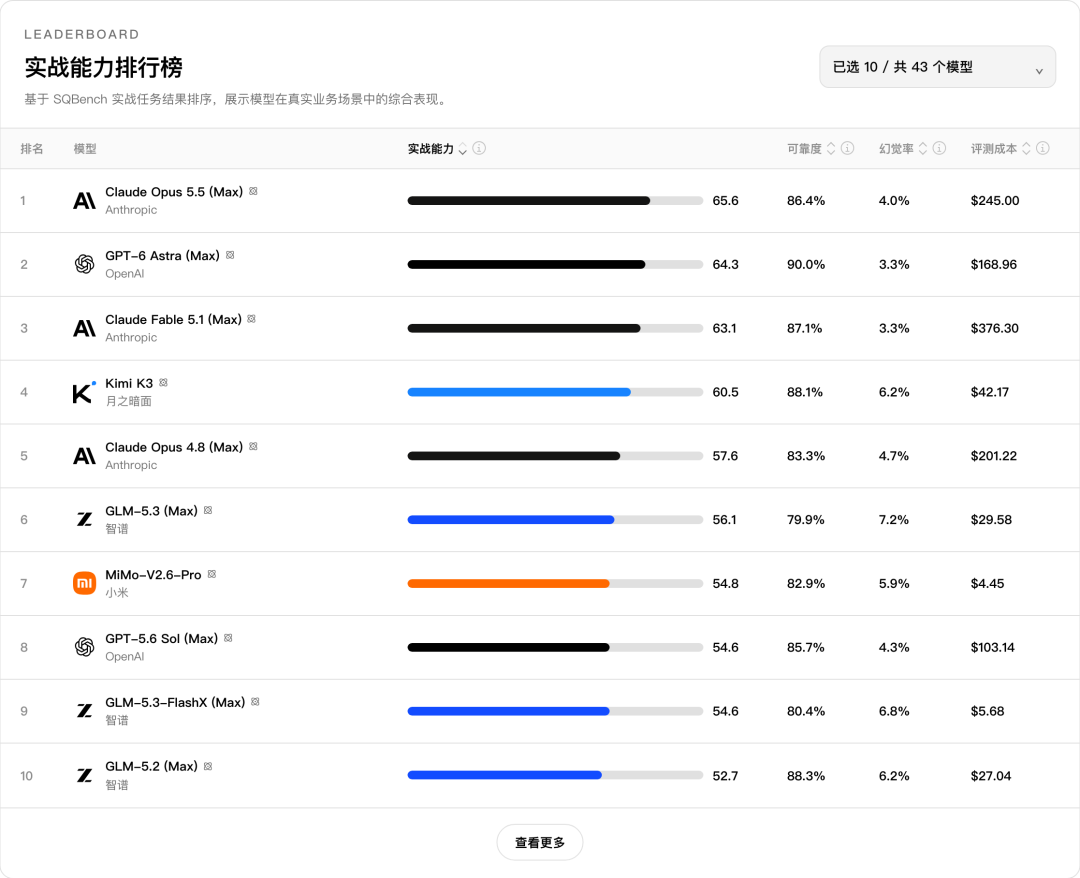
图2:SQBench官方实战能力排行榜实截。
更值得展开的,是它在金融、工业等行业任务中的进步,以及这次升级背后的共同方向:大模型厂商正在把更强的能力,放进越来越低的价格区间。
01
向行业场景进发,金融任务提升最突出
在此前的SQBench评测中,一个反复出现的现象是:模型已经能较好地处理数据分析、代码修改等通用工作,但面对金融、工业、医疗和政务中的完整业务任务,通过率会明显下降。
Opus 5.5的发布很明显在行业业务能力上下了很大功夫。在60项行业业务任务中,它通过27项,通过率45%,高于Fable 5.1的25项和Astra的23项,也是目前这组成绩中的最高值。
模型/配置 | SQBench实战能力 | 复合技能场景通过率 | 行业业务场景通过率 |
Claude Opus 5.5(Max) | 65.6 | 70.0% | 45.0% |
GPT-6 Astra(Max) | 64.3 | 71.7% | 38.3% |
Claude Fable 5.1(Max) | 63.1 | 66.7% | 41.7% |
Claude Opus 4.8(Max) | 57.6 | 66.7% | 25.0% |
复合技能与行业业务各包含60项任务,任务内容不同;实战能力为分层加权得分。Opus 4.8是SQBench已有的同系列历史对照,本次没有Opus 5的同口径结果。
与Opus 4.8相比,行业业务通过率从25%升至45%,多通过12项。与目前领先的Fable 5.1和Astra相比,优势则小得多。这说明Opus 5.5已经进入行业能力的最前列,也说明领先模型之间仍是具体任务上的竞争。
把四个行业分开看,金融最为突出。
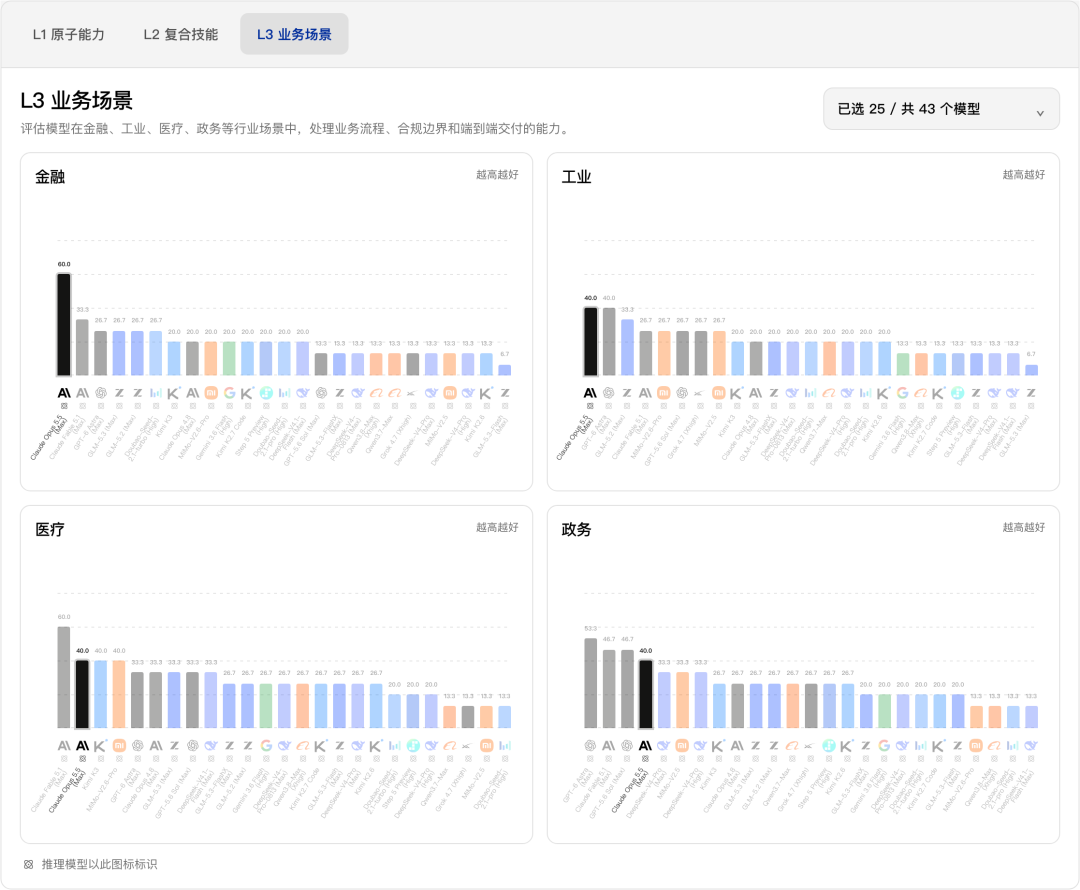
图3:SQBench官方“L3业务场景”截图。
Opus 5.5的金融通过率达到60%。逐项对照Fable 5.1,它保留了对方通过的全部5项任务,并新增通过金融风险分析、策略组合再平衡审查、现金支付事件差异审计、家族企业信息与股权审计4项任务。工业方向也保留了Fable 5.1的全部通过项,并新增通过纠正性工单打包审计、空气处理机组规则持续性异常审计2项任务。
这些任务名称指向的是企业中更具体的工作:对账、审计、风险分析、设备异常检查。它们要求模型在一组业务约束下完成任务。相较只看回答是否流畅,这类结果更有助于判断模型能在哪些工作中减少人工处理。
本轮最有价值的进步,是更多金融、工业任务达到了完整通过的标准。金融不再只是少数任务通过,工业中的审计任务也有了新增通过项,行业能力的提升有了更具体的落点。
但领先也没有覆盖所有行业,在医疗任务中,Fable 5.1通过9项,Opus 5.5为6项;政务任务中,Astra通过8项,Opus 5.5为6项。
即便是Opus 5.5,60项行业任务中也还有33项没有完整通过。金融数理审计通过4/5,但金融合规风控只有2/5;工业数理审计同样通过4/5,工业复杂业务和合规风控则各为1/5。计算、核对方面的进展,尚未均匀延伸到复杂流程与边界约束。
这也让45%的意义更加清楚:行业能力在提高,可承接的工作范围在扩大,完整业务交付仍然是前沿模型需要继续攻克的难题。
02
顶尖智力的降价,“又强又便宜”正在成为行业共识
Opus 5.5的另一项变化,是价格。
API标准单价 | Opus 5 | Opus 5.5 | 降幅 |
非缓存输入 | $5 | $4 | 20% |
输出 | $25 | $20 | 20% |
缓存读取 | $0.50 | $0.20 | 60% |
单位为美元/百万Token,采用官方标准服务报价。
这里有两层节省。第一层是每个Token更便宜;第二层是按官方测试,完成同类工作需要的Token也更少。官方所说的典型工作负载费用降低40%,包含这两种因素,适用的是其默认设置下的测试,不能直接套到所有任务和推理档位上。
回到SQBench,Opus 5.5本轮评测成本比Fable 5.1低34.9%,实战得分为65.6,高于Fable 5.1的63.1。在这组对照中,低费用与高成绩同时出现。
若比较API标准单价,Opus 5.5的输入、输出报价均为Fable 5.1的四成,低60%;缓存读取为每百万Token 0.20美元,比Fable 5.1的0.25美元低20%。整轮费用差异既受Token用量影响,也取决于输入、输出及缓存等不同计费项的占比,不能仅凭某一项单价的降幅推算。
但它的便宜有明确的参照。Astra完成本轮评测的费用约168.96美元,仍低于Opus 5.5。这也提醒用户,API单价只是账单的一部分:不同模型消耗的Token、缓存命中情况和任务执行过程都会影响最终费用。
如果把国内模型放进来,整个市场的变化会更清晰。
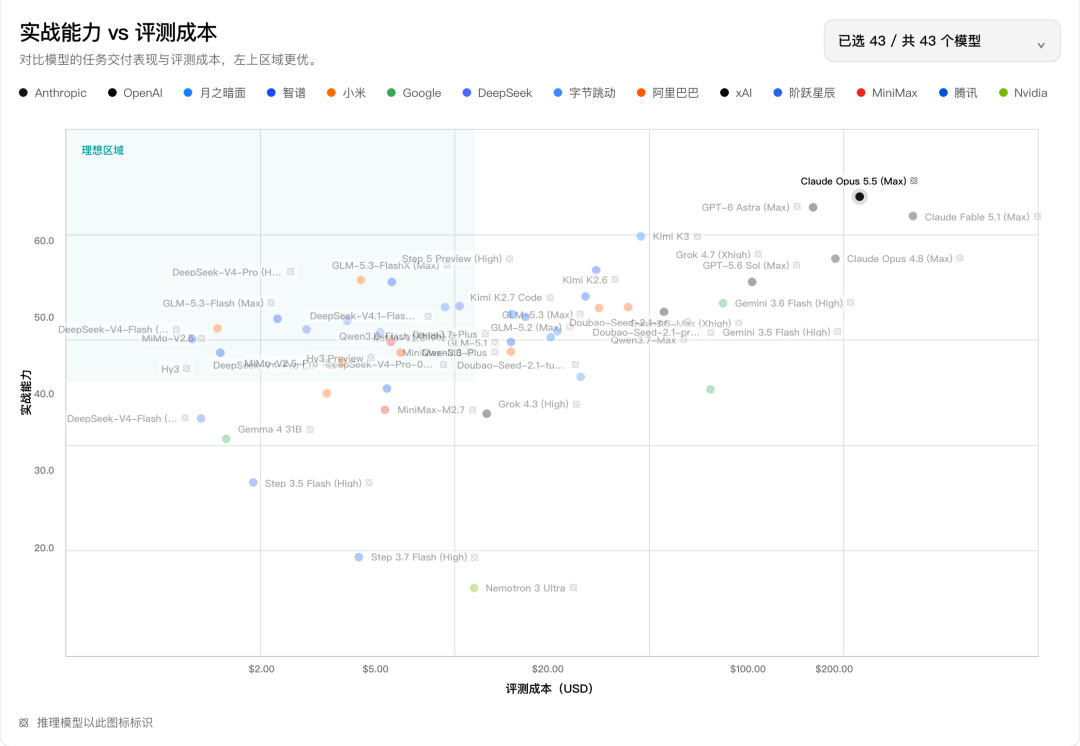
图4:SQBench网站“实战能力 vs 评测成本”截图。
模型/配置 | SQBench实战能力 | 整轮评测费用 |
Claude Opus 5.5(Max) | 65.6 | $245.00 |
GPT-6 Astra(Max) | 64.3 | $168.96 |
Claude Fable 5.1(Max) | 63.1 | $376.30 |
GPT-5.6 Sol(Max) | 54.6 | $103.14 |
GLM-5.3(Max) | 56.1 | $29.58 |
GLM-5.3-FlashX(Max) | 54.6 | $5.68 |
MiMo-V2.6-Pro | 54.8 | $4.45 |
费用按各模型评测时的渠道、用量与价格快照核算,不能当作按今天价表统一重算的结果;不包含现实应用中的人工复核、系统集成等成本。
GLM-5.3 flashX以GLM-5.3约19.2%的评测费用,取得54.6分,与GLM-5.3相差约1.5分。MiMo-V2.6-Pro则以比GLM-5.3 flashX更低的评测费用,取得54.8分。这些模型在综合得分上距离Opus 5.5仍有差距,但已经让较低预算下的实际工作能力变得相当可观。
国内厂商也在同时改善速度和使用成本。智谱将FlashX的官方推理速度提高到200 Token/秒;小米则明确表示,MiMo-V2.6系列升级后API价格维持不变,并开放模型权重及配套研究资源。能力提升、服务提速和价格竞争,正在一起发生。
OpenAI的产品线也呈现出类似变化。8月21日,GPT-5.6 Sol的输入、输出价格分别下调20%和33%,目前为每百万Token 4美元和20美元;GPT-5.6 Luna则在7月30日降价80%,目前输入0.20美元、输出1.20美元。Sol当前为优惠价格,官方承诺至少持续至11月21日;上述均为标准短上下文报价。
Sol面向复杂专业工作,Luna面向对费用敏感的大规模任务,两者承担不同角色。SQBench当前尚无Luna成绩,因此不能把它的低价写成已经验证的同等实战能力。但从产品布局可以看到,厂商既在争夺最高能力,也在扩大低成本模型能够服务的工作范围。
这种趋势已有长期研究支撑。斯坦福《Artificial Intelligence Index Report 2025》指出,从2022年11月至2024年10月,达到GPT-3.5相当水平的系统,其推理成本下降超过280倍。这里衡量的是获得同一能力水平需要多少钱。
2026年3月修订的研究《The Price of Progress》进一步汇总了Artificial Analysis和Epoch AI的数据:在知识、推理、数学和软件工程基准上,获得固定表现水平的价格,按其研究口径每年下降约5至10倍。研究同时发现,追逐最前沿能力的模型运行费用可能上升,因为模型规模和推理用量也在增长。
这两件事可以同时成立:最高能力仍然需要投入,而此前昂贵的能力会逐步进入更便宜的产品。Opus 5.5相对Fable 5.1的表现与费用、Sol和Luna的价格调整,以及FlashX、MiMo在低价区间的竞争,正从不同方向呈现这一变化。
对企业来说,这意味着更多工作有机会从“试一次”,变成“每天都用”。一份报告可能需要多轮资料核对,一次设备异常分析可能涉及多次数据检查。当模型更容易完成任务、每轮调用也更便宜时,团队就能在同样预算下处理更多材料、增加验证,或覆盖更多业务环节。
最终还要看每份合格交付的总成本,其中既包括模型费用,也包括返工和人工复核。今天的SQBench仍显示,行业任务距离普遍可靠的完整交付还有距离;但能做的事情更多、取得这些能力的价格更低,已经是可以观察到的进步。
Opus 5.5的意义,是把领先的行业能力放到了比Fable 5.1更低的费用水平上。更值得期待的下一步,是这样的进步继续向各个价格区间扩散,让更多企业和普通使用者,都能负担得起更复杂、更有价值的工作。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅