
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
DeepSeek V4 Pro-0813(Max)、Qwen3.8-Max(Xhigh)和Doubao Seed 2.1 Turbo(High)的纯智力评测、Agent任务等刷题评测已经比较多了,那在实战业务能力的表现到底谁更强?近期SQBench发布了这三款模型的实战能力评测成绩。下文分别简称DeepSeek、千问和豆包。
三款模型的综合实战得分依次为51.40、51.33和51.33,差距不到0.1分。
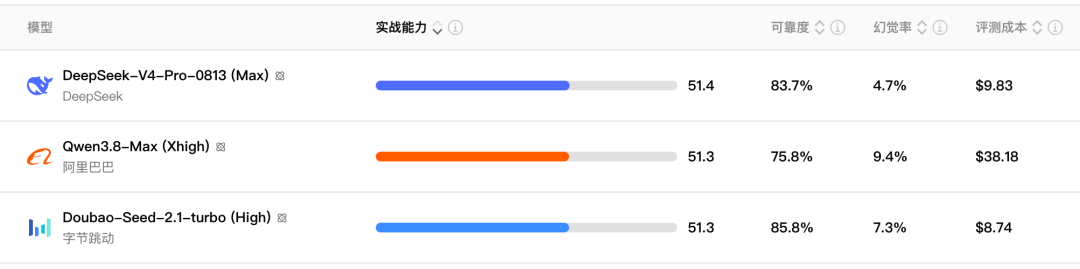
图:SQBench原页面截图,图中得分保留一位小数。
DeepSeek被不少用户称为大模型竞争的“斩杀线”。但总分如此接近,三款模型具体该怎么选?谁在哪些工作上更有优势,又有哪些短板?
逐项比较后的结论是:DeepSeek的行业场景表现更好,千问在本轮“智力”项中领先,豆包的软件工程交付更出色。三家总分接近,擅长的工作却差异很大。
01
DeepSeek:行业场景更胜一筹
对于需要处理行业材料、遵循业务规则的工作,DeepSeek更值得优先考虑。
SQBench的行业场景(L3)覆盖金融、工业、医疗和政务。60项任务中,DeepSeek的平均最终表现分为83.36,千问为74.64,豆包为71.20。政务和医疗是它优势比较明显的两个方向。
这一层考察的工作包含数理审计、复杂业务处理和合规风控。模型需要把材料中的要求落实到计算、判断和交付文件里。对于正在给企业业务选择模型的团队,这组结果比单看代码题成绩更有参考价值。
DeepSeek的优势也体现在较少的幻觉相关风险上。行业场景中,它的幻觉率为6.67%,千问和豆包分别为15.00%、16.67%。涉及材料引用、数据来源和业务判断时,这个差别值得重视。
不过,DeepSeek没有在所有行业方向上领先。金融复杂业务的平均表现低于另外两家,合规风控整体不如豆包。行业场景完整通过的任务数,也是豆包比它多一道;DeepSeek领先的是这一层的平均表现。
DeepSeek适合优先用于行业场景,但并非每个方向都领先。到了软件工程任务,豆包有更好的成绩。
02
千问:“智力”表现最强
这里的“智力”项,看的是SQBench的原子能力(L1),包括指令遵循、长文本推理、动态代码逻辑,以及鲁棒性与边界处理。
100项任务中,千问完整通过60项,DeepSeek为57项,豆包为45项。千问在三者中排在前面,最突出的成绩是动态编程:25题全部完整通过。
这类任务要求模型读懂程序如何执行,跟踪排序、删除、覆盖等操作带来的变化,有时还要根据最终输出反推原始输入。千问把这一组任务的答案和交付要求都完成了。
千问领先,但与DeepSeek的距离很小。它的原子能力平均最终表现分为84.48,DeepSeek为84.34,几乎持平;指令遵循和长文本推理的通过数,两者也相同。部分代码题的分差还来自格式、解析等要求,不能全部算成推理能力的差距。
千问也能完成具体的数据工作。消费者需求分析任务中,它清理了数据库里的异常值,处理了季节性影响,导出结果,并结合历史市场资料写出分析报告。数据分析15项任务,它完整通过12项,多于另外两家的10项。不过,剩余3项均为0分,使它的平均得分反而低于两家。
千问的原子能力成绩值得认可,但这种领先尚未全面转化为业务优势。软件工程任务中,它的通过数少于DeepSeek和豆包。本轮记录费用也更高:千问38.18美元,DeepSeek9.83美元,豆包8.74美元。对已经使用其他模型的团队,换用千问仍要看具体任务能得到多少改善。
03
豆包:工程交付更出色
在复合技能场景(L2)的软件工程任务中,豆包通过10项,DeepSeek通过9项,千问通过8项,每家面对的都是15项任务。平均最终表现分也是豆包最高。
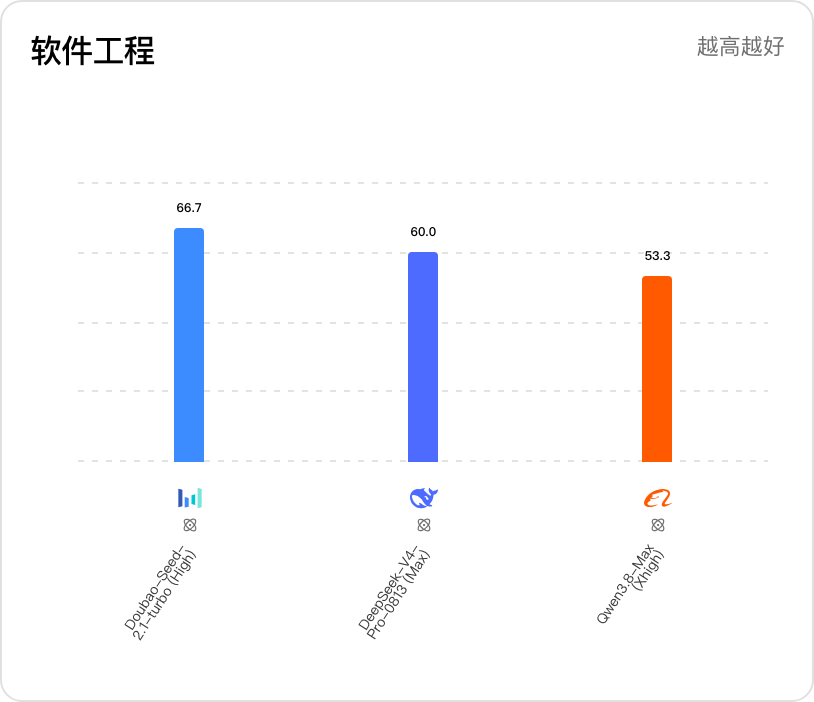
图:SQBench软件工程分项原页面截图,显示完整通过率,每款模型15项任务。
电商缓存重构这道题,很能说明工程交付的要求。
任务中的商品页面把基础信息、区域价格、用户折扣和库存放进同一个缓存键,命中率低,访问也慢。模型需要拆分缓存、修改代码、运行模拟压测,再提交一份架构报告,解释问题出在哪里、为什么这样改。用户折扣还必须彼此隔离,不能把一个人的优惠给另一个人。
豆包的评测记录为完整通过。千问做了部分代码改造,命中率达到要求,也在一次最终压测中达到延迟目标,却没有提交规定的架构报告。DeepSeek同样漏交了报告,最后一次测试的延迟也未达标。
对于接手代码的工程师,设计说明有实际用途:哪些数据可以共用缓存,哪些必须按用户隔离,各类数据能容忍多久的更新延迟,都需要有清楚的依据。代码有了,约定的说明材料没交齐,任务就还没有按要求完成。
在这一组任务中,豆包比另外两家交出了更多完整结果,值得进入工程选型的候选名单。千问代码题全部通过,到了需要修改、验证和提交材料的工程工作,排名却发生了变化。
豆包也有短板。它在长文本推理中的完整通过数明显偏少,行业场景中的复杂业务和数理审计平均表现也落后于另外两家。因此,软件工程表现好,并不意味着所有行业工作都适合换成豆包。
04
总结:三款模型,按工作选择
做行业场景,优先考虑DeepSeek;智力任务,千问领先;做软件工程,豆包值得重点考虑。
三款模型的短板同样明确:DeepSeek在合规风控上不及豆包;千问的原子能力优势没有全面转化为业务交付优势,整体成本也更高;豆包则在长文本推理、复杂业务和数理审计上有所欠缺。
这组结果没有选出一款万事通的模型。大家可以从实际工作出发,把完成情况、风险和成本放在一起比较,而不必根据总榜上不到0.1分的差距决定选择。
数据说明:本文采用SQBench三款配置各220项标准化任务的单次评测记录。综合实战得分由原子能力、复合技能场景、行业场景的完整通过率按20%、60%、20%加权;平均最终表现分包含部分完成与风险扣减,按百分制展示。“智力”项仅指本文比较的原子能力,不代表通用智商排名。费用为各次运行按当时价格记录的API支出,不同运行日期的费用不等同于当前报价。豆包案例依据逐题汇总结果,其他两款另核对了执行记录。
资料来源:SQBench三款模型的评测记录及原页面图表。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅