
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
DeepSeek V4.1 Flash发布时,称其“在基准测试中,成功超越了包括 DeepSeek V4 Pro 在内的一众旗舰模型的智能水平”,真的是这样吗?官方发布的具体性能对比图如下:
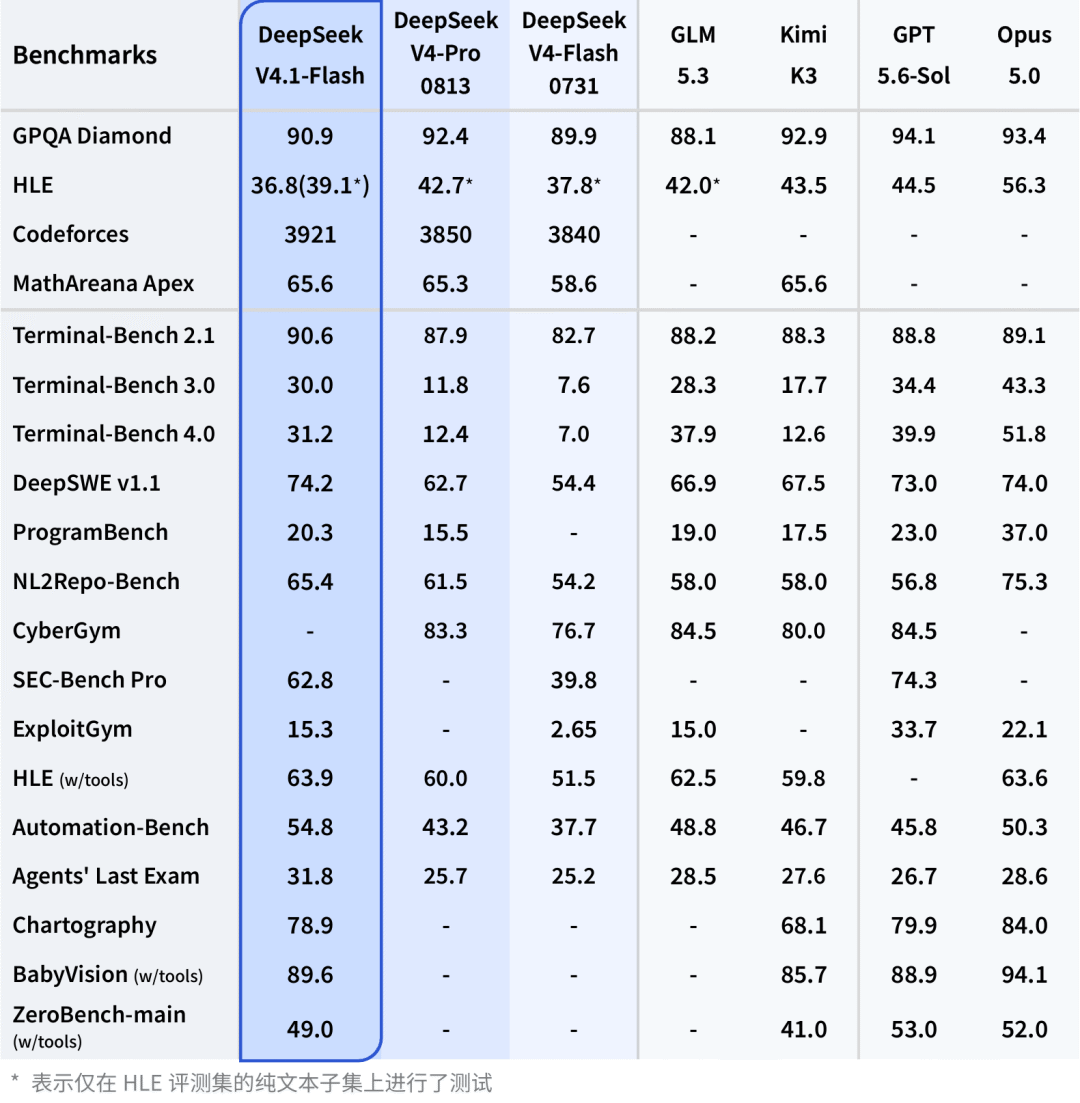
图:DeepSeek官方发布的V4.1 Flash基准测试性能对比,含推理与Agent任务。
从官方发布的基准测试的对比图来看,在主流的Agentic Benchmark上,V4.1 Flash的确超越了V4 Pro和部分主流国产模型,但这意味着V4.1 Flash已经可以替代其它模型了吗?特别是对于用V4 Pro的用户来说,可以完全替代了吗?
这个问题在沙丘社区SQBench基于真实业务的实战评测中,有了更明确的答案,V4.1 Flash在原子能力任务中的通过率更高,但在真实业务的评测中,V4 Pro的表现更出色,整体得分也更高。
本文评测的V4 Pro为0813版本,两款模型推理级别均设置为Max。
01
V4.1 Flash在编程、长上下文等智力相关任务上占优
SQBench的原子能力(L1)包含100项任务,考察指令遵循、长上下文推理、动态代码逻辑,以及鲁棒性与边界。V4.1 Flash通过65项,V4 Pro通过57项。四个方向中,V4.1 Flash在前三个方向领先,优势最明显的是动态编程。
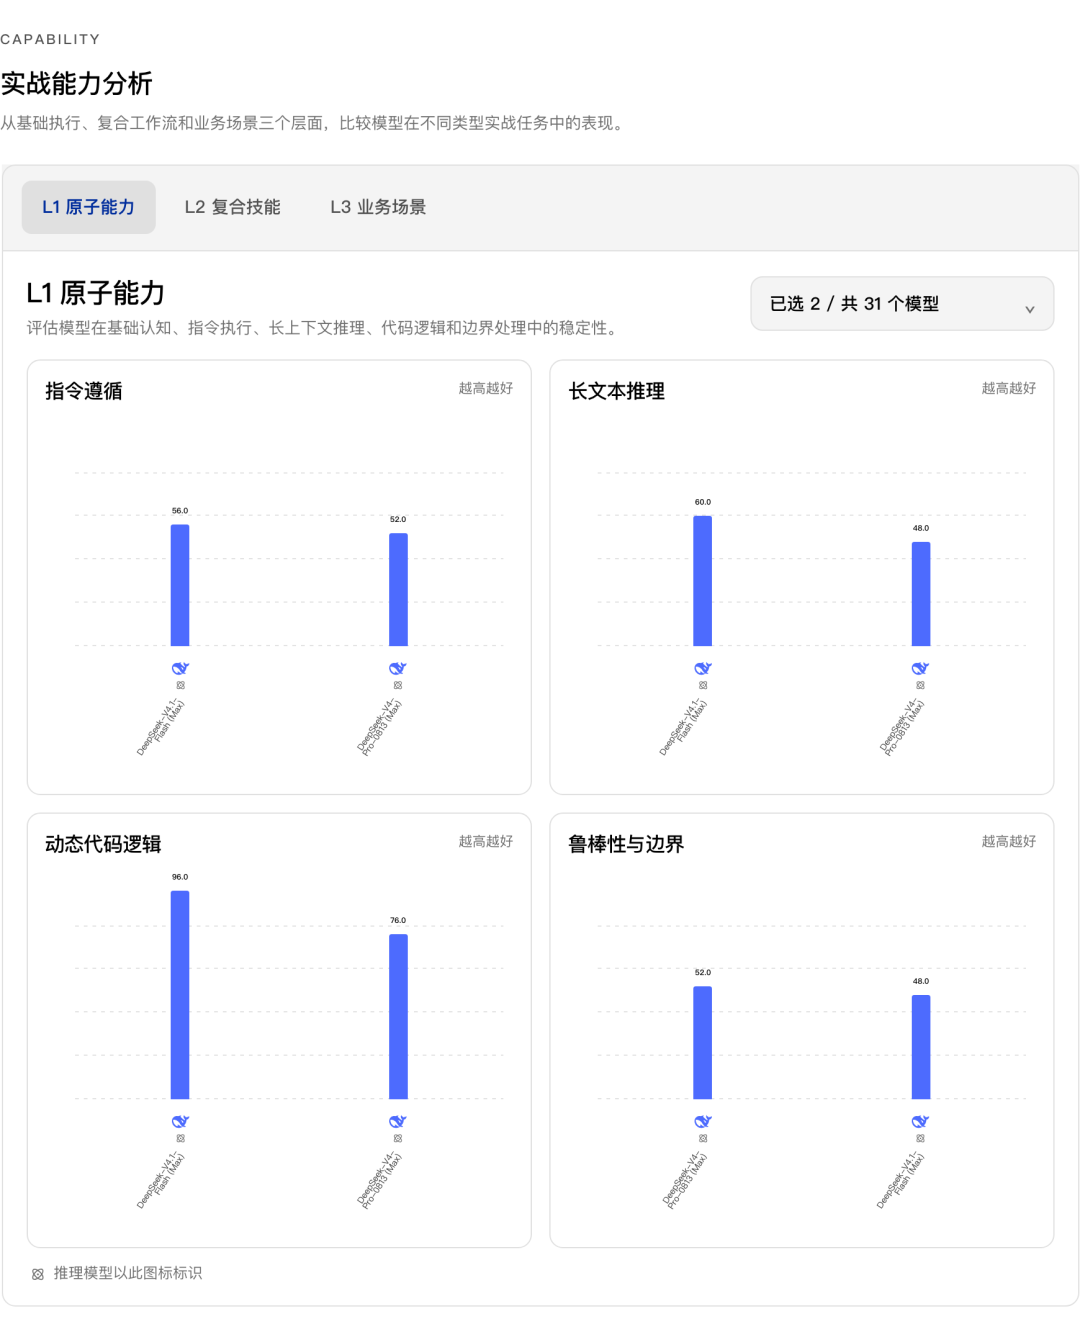
图:SQBench原子能力四分项通过率,每组25项任务,两款模型均为Max。
25道动态编程题,V4.1 Flash通过24道,V4 Pro通过19道。长上下文和指令遵循两组,也都是V4.1 Flash的通过数、平均最终表现分更高。它的进步同时体现在程序逻辑、长材料中的推理,以及按指令完成任务几个方面。
一道代码推理题能说明这种差别。模型拿到一段会反复排序、删除和重新插入元素的Python程序,需要根据最终输出反推原始输入,再提交答案文件。V4.1 Flash找到了符合要求的输入,文件通过了六项自动检查;V4 Pro进行了推导和候选枚举,但这次运行结束时没有交出文件。
在这类目标明确、结果可以直接验证的基础任务中,V4.1 Flash交出了更多完整答案。对主要用模型处理程序逻辑和长文本推理的开发者,这轮提高值得重视。
鲁棒性与边界则是V4 Pro更好,这一组也使它的原子能力平均最终表现分略高于V4.1 Flash。V4.1 Flash此次领先的是整体通过率,以及编程、长上下文和指令遵循三个方向。
02
V4 Pro的业务能力整体更强
把任务换成办公、研究和行业工作,结果就不同了。在本轮SQBench业务评测中,V4 Pro仍是整体表现更好的模型。
在复合技能场景(L2)的60项任务中,V4 Pro通过36项,V4.1 Flash通过31项。办公协作、数据分析、深度研究三个方向,V4 Pro通过的任务更多;软件工程通过数持平。四个方向的平均最终表现分,全部是V4 Pro更高。
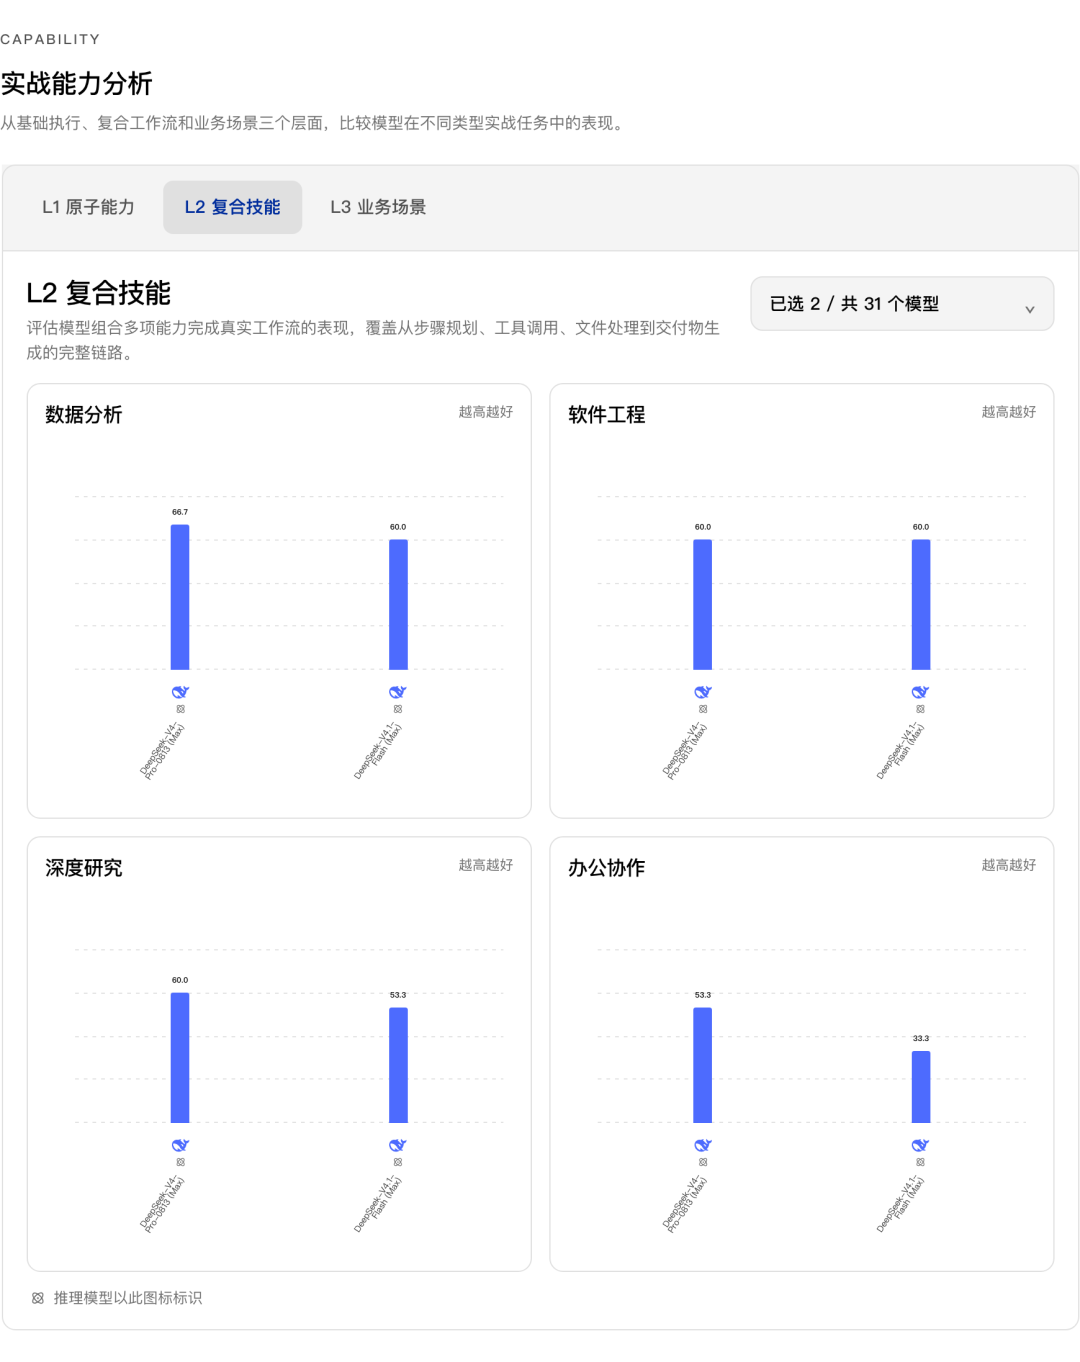
图:SQBench复合技能场景四分项通过率,每组15项任务。V4 Pro在办公协作、数据分析和深度研究领先,软件工程持平。
办公协作的差距最明显,V4 Pro通过8项,V4.1 Flash通过5项。这类工作通常要读懂材料、处理文件,再把结果按要求交出来。V4.1 Flash在指令遵循和长上下文上的优势,尚未转化为更好的整项工作表现。
软件工程也有类似情况。V4.1 Flash在原子能力的动态编程任务中领先,到了复合技能场景的软件工程任务,双方却都通过9项,V4 Pro的平均最终表现分更高。代码推理能力提高之后,分析、修改、验证和交付能否一起完成,仍然需要单独看。
推荐系统升级调查这道题中,新模型上线后离线指标提高,线上点击率却下降。任务要求调查原因、修复代码、运行压测,并提交说明原因及实验问题的审计报告。
两个模型都修改了代码,也都让给定压测中的1,000次请求没有触发回退。V4 Pro随后生成了审计报告;V4.1 Flash的运行记录在压测通过后结束,没有提交报告。
同样通过了代码测试,交付的完整程度却不同。团队还需要知道离线评估为什么失效、A/B实验是否受到同期推送策略变化的干扰,以及下一次该怎样验证。报告缺失,就意味着这些分析工作还没有按要求交齐。
行业业务场景(L3)进一步加入金融、工业、医疗和政务等行业要求。60项任务中,双方各通过12项,但V4 Pro的平均最终表现分为83.36,V4.1 Flash为77.62;拆到四个行业,平均最终表现分也均为V4 Pro更高。
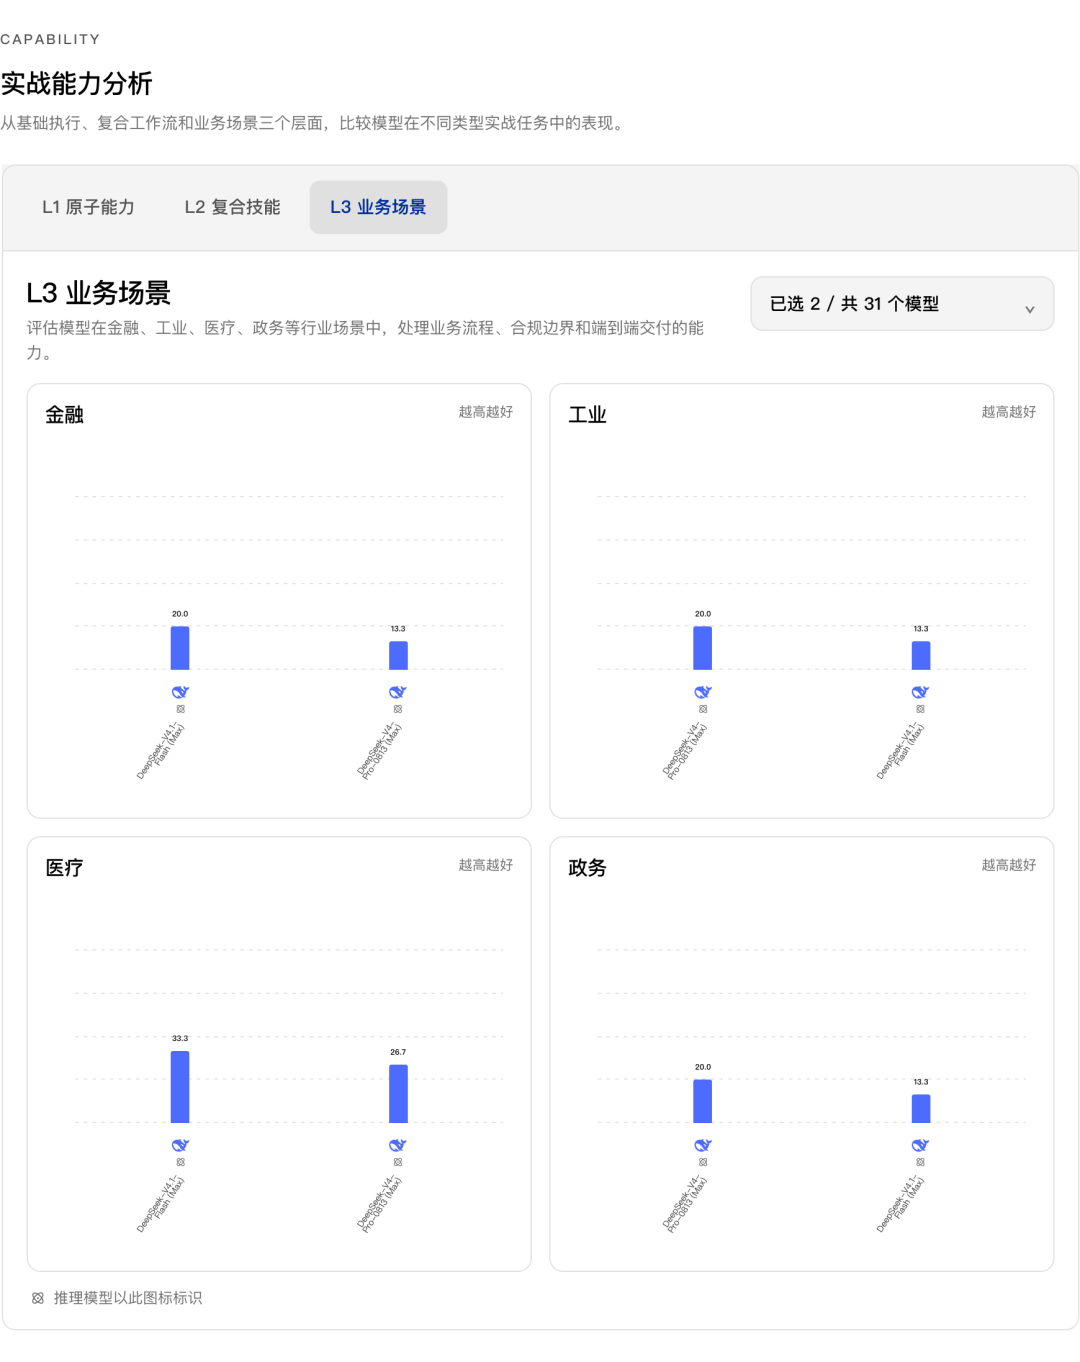
图:SQBench行业业务场景分行业通过率,每个行业15项任务。通过数各有胜负、合计持平;平均最终表现分另见正文。
行业业务场景中,两款模型都能完成部分工作。V4 Pro的优势在于整体完成质量更高,这也是它在业务选型中仍值得保留的原因。对于要求分析有依据、文件能使用、材料交齐的工作,复合技能场景和行业业务场景的结果比单看代码推理成绩更有参考价值。
03
总结:基础任务用V4.1 Flash,业务工作交给V4 Pro
本轮结果给出的选择很明确:动态编程、长上下文和指令遵循,V4.1 Flash表现更好,模型调用费用也比V4 Pro低约47%;办公、研究和行业业务任务,V4 Pro的整体表现仍然领先。
V4.1 Flash值得用,它已经在一些能力上超过V4 Pro。但对于正在用V4 Pro承担业务工作的团队,目前的结果支持按任务替换,而非整体迁移。把V4.1 Flash用在已经显示优势的工作上,继续让V4 Pro承担它做得更好的业务任务,是这轮评测更有依据的选择。(其实,大家强烈反馈官方留下的V4 Pro是其价值最大的证明)
数据说明:本文比较V4.1 Flash(Max)与V4 Pro(0813版本,Max)在SQBench标准化环境中的220项同题单次评测结果。L1为原子能力,L2为复合技能场景,L3为行业业务场景。“通过”指达到完整交付标准;平均最终表现分包含部分完成得分及风险扣减,正文按百分制展示。费用为本轮记录的模型API费用。
参考资料:DeepSeek官方发布公告及基准图;SQBench评测方法论与两款模型评测记录。开头基准图为DeepSeek官方报告结果,正文三张能力图均为SQBench原页面截图。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅