
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
9月18日,智谱推出GLM-5.3-Flash的高速型号GLM-5.3-FlashX,主打最高每秒200个token的推理速度。据智谱披露,这次提速是在既有国产芯片算力基础上,进一步投入推理优化的结果。
SQBench最新公布了GLM-5.3-FlashX的实战能力评测成绩,相比5.3-Flash,综合实战能力从49.73提高到54.60,整体表现直逼智谱的旗舰模型GLM-5.3。5.3-FlashX花费约为GLM-5.3的两成,用时约为三分之一,综合成绩仅相差1.46分。
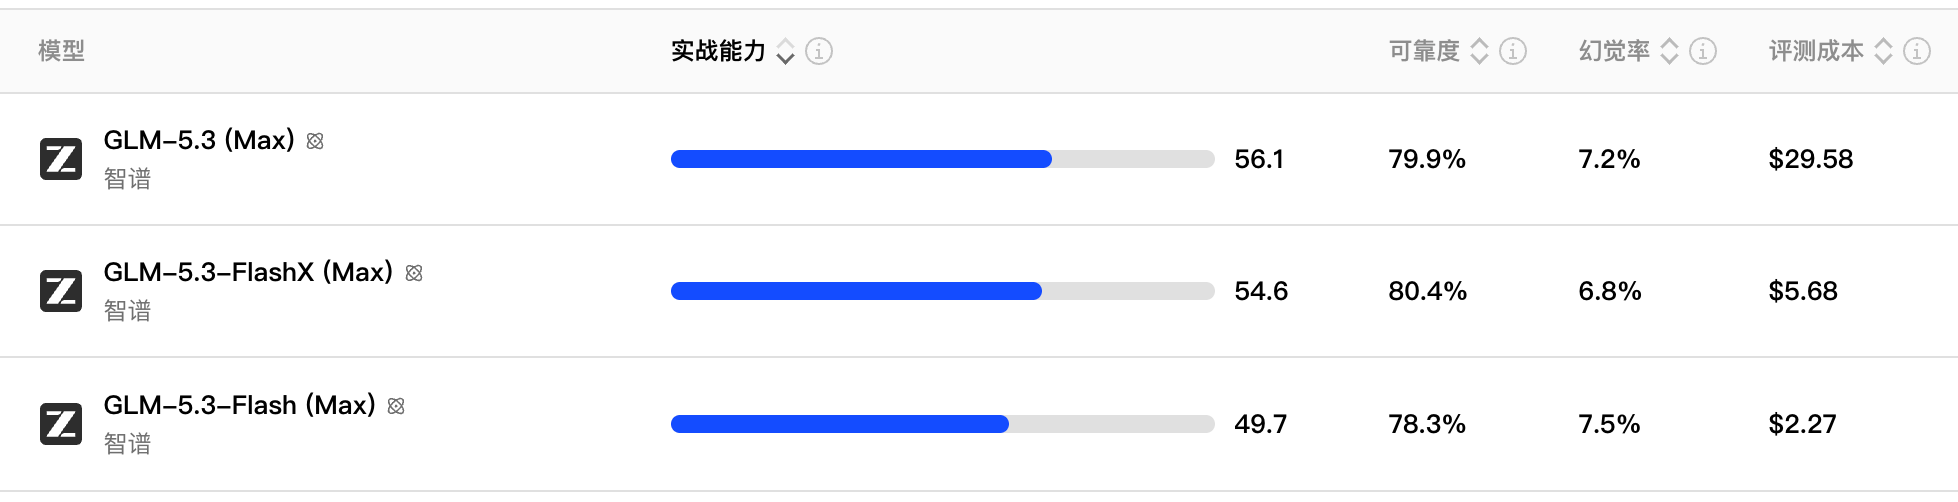
图:SQBench实战能力对比
这次评测包含220项任务,三款GLM模型均使用Max配置。我们挑出研究报告、代码修复和部门周报三项工作,看看5.3-FlashX究竟快在哪里。这三项任务,三款模型都通过了评测,交付物和完成用时可以直接对照。
01
写研究报告:15分半的等待,缩到了2分多钟
先给模型一项白银市场研究:回顾2010年以来的行情,分析通胀、工业需求和美元走势等驱动因素,再整理延伸至2030年的展望。报告需要有检索来源、分阶段的分析和思维导图。
这份任务从查资料开始,直到报告落到文件里,GLM-5.3用了15分29秒,5.3-Flash用了8分48秒。5.3-FlashX用了2分15秒。
打开5.3-FlashX交出的报告,可以看到历史梳理、驱动因素、技术位置、未来情景和资料来源几个部分。它把不同期限的判断拆开,同时列出可能推动或改变这些判断的条件。
例如,报告在讨论长期需求时,把光伏用银放在了重要位置;在另一种情景里,又考虑了光伏技术降低单位用银量、矿山供应增加等因素。最后列出的观察项,包括交易所库存、保证金政策和光伏电池单位用银量。方法说明中,它还列出了不同来源的数据差异,并注明对短期预测的置信度较低。
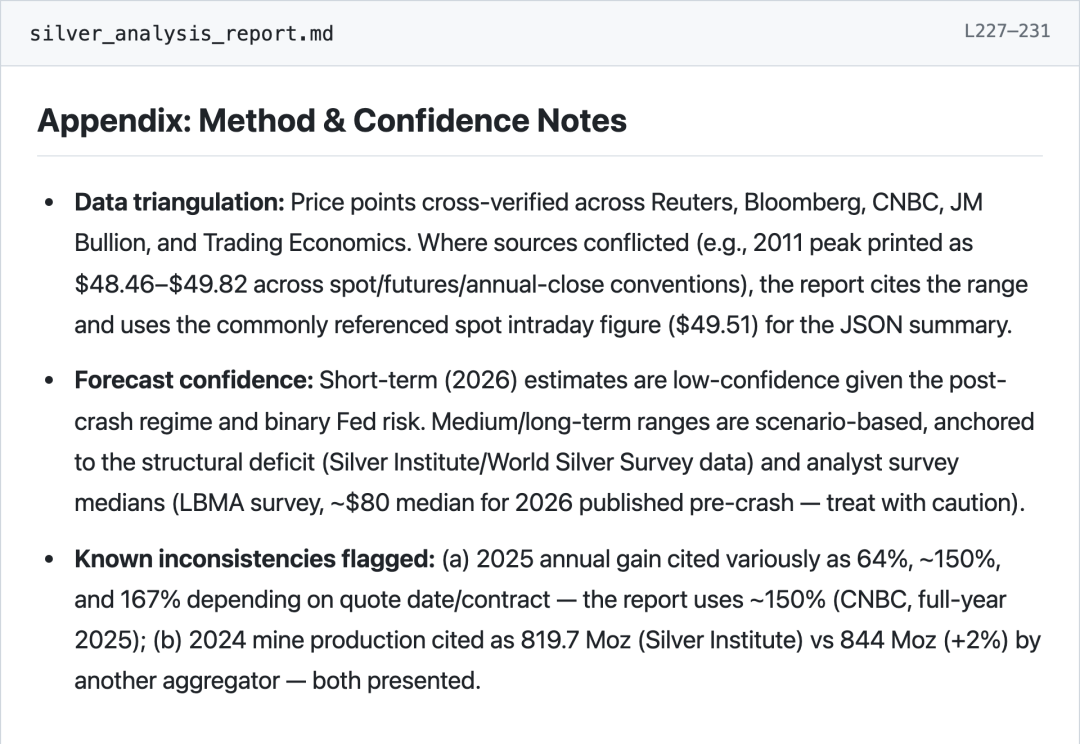
图:silver_analysis_report.md原文节选,展示数据核验、预测置信度与来源差异说明。按原始文件内容渲染。
对研究工作来说,这些细节有用。读报告的人可以沿着观察项继续查资料,核对某个判断的依据,也能看出哪些条件变化后,原来的分析需要调整。报告尾部的检索来源,则留下了进一步核验的入口。
02
修代码:一个并发漏洞,57秒修完并通过测试
接口规定每人每秒最多请求5次,遇到50个并发请求时,却几乎全部放行。
这是SQBench中一道分布式限流修复任务。模型要读代码、找到漏洞、完成修改,写出原因说明,并运行测试。验收要求很清楚:50个并发请求,恰好5个通过。
5.3-FlashX完成这项工作用了57秒。 5.3-Flash用了3分58秒,GLM-5.3用了6分02秒。
原来的代码把读取计数、判断限额和更新计数分成了几个步骤。多个请求同时到达时,可能读到同一个旧值,各自判断“还没超额”,于是限流失效。
5.3-FlashX把共享计数的更新交给Redis的原子递增操作,再根据返回的计数判断是否放行。它还在报告里解释了为什么给客户端加一把锁不够:任务中的服务运行在多个独立实例上,各自的本地锁管不到其他实例。
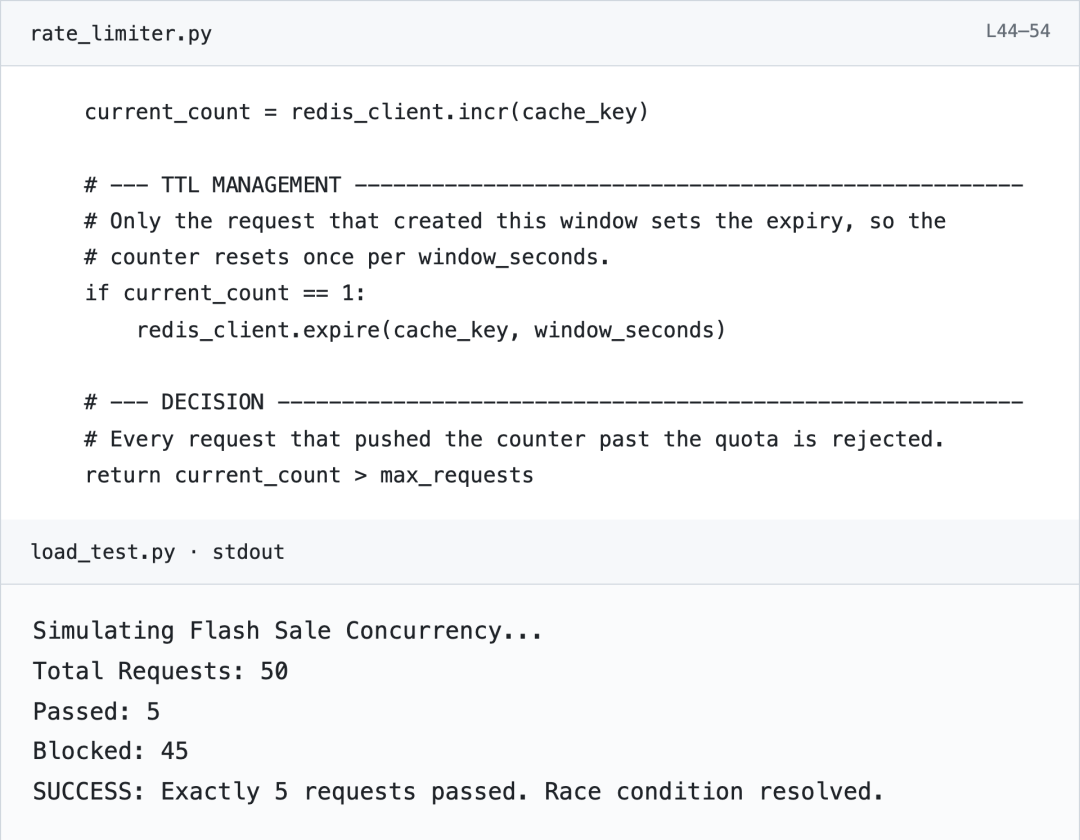
图:rate_limiter.py原始代码节选及本次评测的测试输出,保留原注释和输出文本。
测试结果是5个通过、45个被拦截。修改后的代码、原因说明和验证结果都交了出来,三款模型也都通过了这项任务。
03
做部门周报:1分40秒,查出了汇报里的“水分”
再看一项更熟悉的工作:给部门负责人整理周报。
SQBench给模型的材料包括团队聊天记录、业务数据表、预算文件和财务规则。聊天记录里的成绩很好看:新增了1200条营销线索,点击成本降到2美元以下,访问量轻松超过目标。写进正式周报之前,这些说法都要核对。
5.3-FlashX先运行脚本清洗和计算数据,再把自报成绩与核对结果放到了一起。
1200条线索,按任务规定调整后只有1092.5条;“低于2美元”的点击成本,实际是2.50美元;所谓“轻松超过”5万访问量,实际恰好5万。
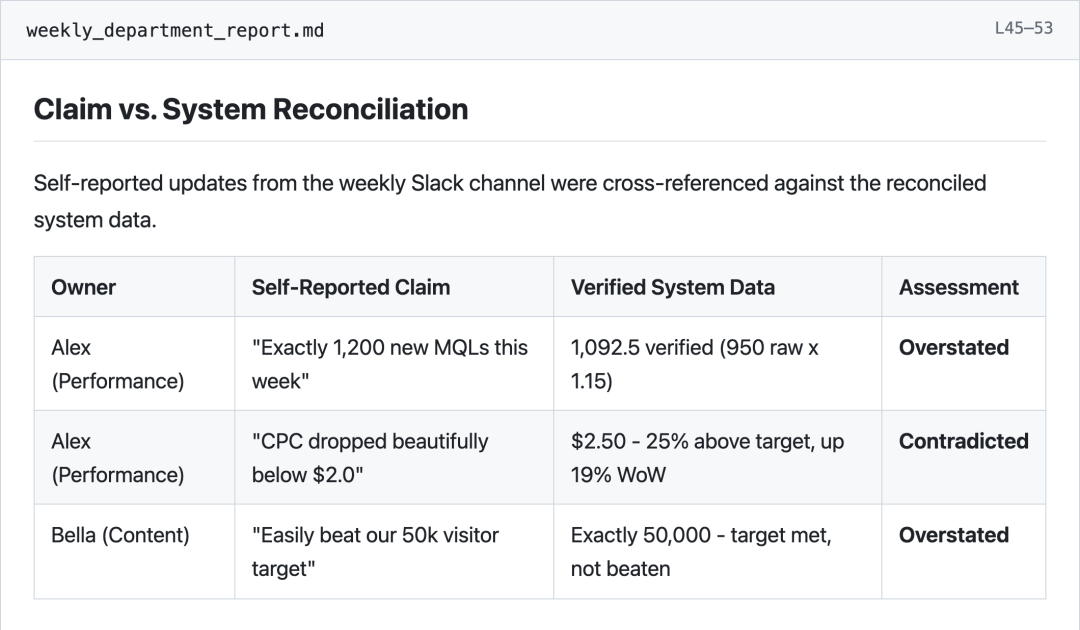
图:weekly_department_report.md原始核对表节选,保留原文四列与前三条核对记录。
报告把这些差异逐条标了出来。哪些数字不符,哪些只是话说满了,部门负责人可以直接找到需要追问的位置。
它也没有把所有发现都塞进周报。按照任务中的保密要求,具体的预算违规进入单独的通知文件,普通部门周报没有披露这些明细。最终交付包括数据处理脚本、部门周报和预算通知。
完成这些工作,5.3-FlashX用了约1分40秒;5.3-Flash用了10分30秒,GLM-5.3用了10分14秒。
04
比它快的得分更低,比它高分的更慢、更贵
把5.3-FlashX放回整个榜单,性价比上的优势更清楚。
下面这张图,横轴是评测费用,纵轴是实战得分。越靠左,费用越低;越靠上,得分越高。5.3-FlashX处在一个醒目的位置:拿到同等或更高实战得分的模型,费用都比它高。
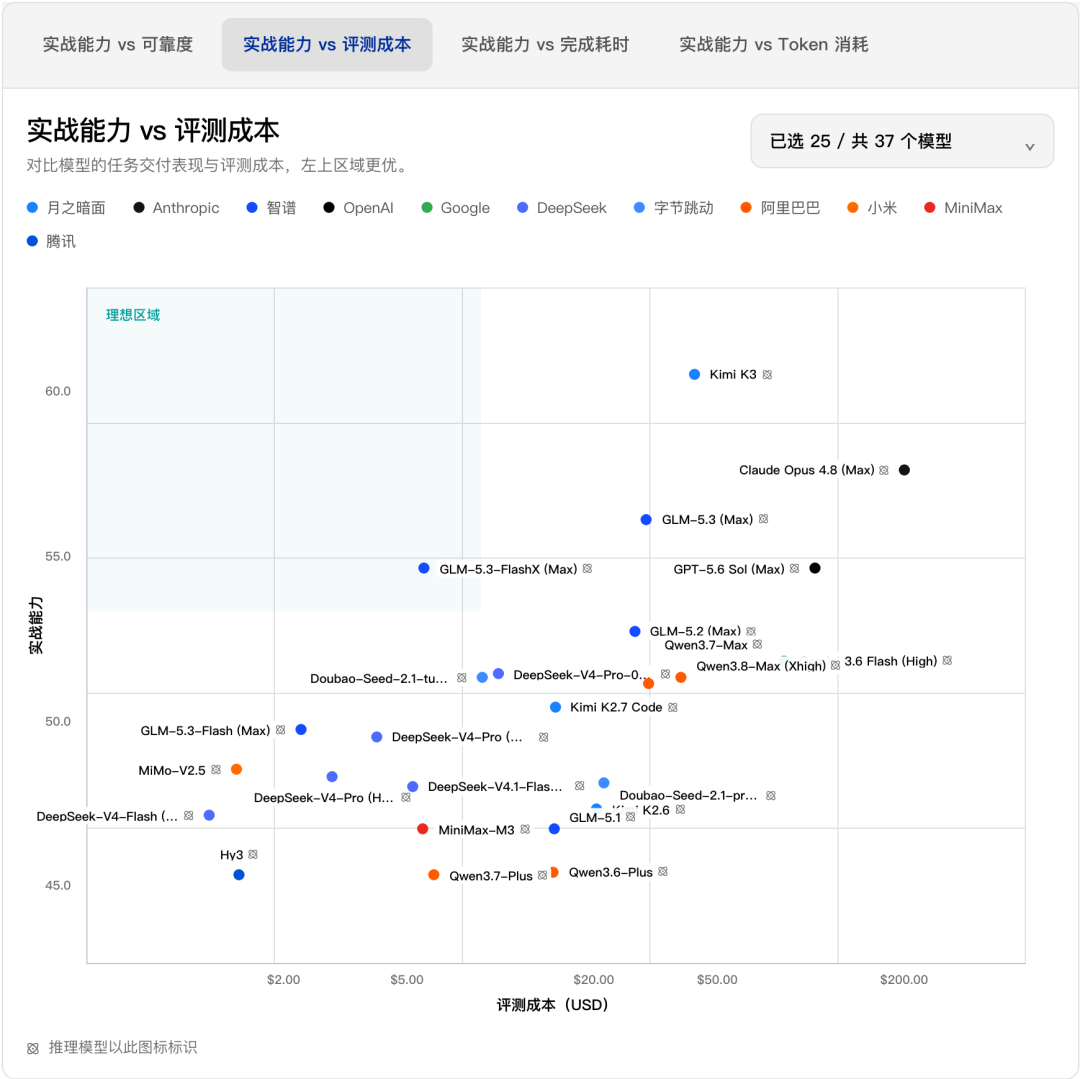
图:SQBench“实战能力 vs 评测成本”原图,展示默认选择的25个模型版本。
再把速度放进来,比较几款用户熟悉的模型:
模型
实战得分
累计耗时
评测费用
DeepSeek-V4-Flash(High)
47.07
5.51小时
$1.15
GLM-5.3-FlashX(Max)
54.60
6.67小时
$5.68
GLM-5.3(Max)
56.06
20.81小时
$29.58
Kimi K3
60.54
18.84小时
$42.17
表:同一组220项任务的累计用时与模型API费用。
DeepSeek-V4-Flash确实更快,也便宜很多。5.3-FlashX多花了约1.15小时和4.53美元,实战得分高出7.53分。前者的低价优势很强,后者则交出了更高的整体成绩。
Kimi K3的得分领先5.3-FlashX约5.94分,但累计用时达到18.84小时,费用为42.17美元。5.3-FlashX的用时约为它的35%,费用约为13%。GLM-5.3同样保持着更高的整体表现,完全通过119项任务,5.3-FlashX通过109项;两者的用时和费用差距,开头已经给出了答案。
我们也核对了截至9月19日SQBench已公布的全部37个模型版本:比5.3-FlashX快的,实战得分都更低;得分比它高的,用时和费用都更高。
称它为“性价比之王”,我们看重的是这组结果:它已经达到较高的实战能力水平,同时把完成工作的时间和费用压到了很低的位置。同分或更高分的参评模型里,它的用时和费用都是最低的。
研究报告2分多钟、限流修复57秒、部门周报不到2分钟,这些交付让“性价比”有了具体内容。5.3-FlashX这次最有说服力的地方,就是较高的实战成绩、短得多的等待和低得多的费用,出现在了同一款模型上。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅