
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
Grok 4.7本次模型发布的重点之一是“更能干,也更划算”,但和国产开源模型相比“既不能干,也不划算”。
9月21日,xAI官方发布了这款面向编程与知识工作的新模型,强调更长时间的复杂任务训练、更主动的自我检查,同时保持与Grok 4.6相同的价格和速度。
放进SQBench的真实任务集,它的综合能力和性价比都面临考验。本轮Grok 4.7采用Xhigh配置,实战能力得分50.6,低于Kimi K3、GLM-5.3、MiMo-V2.6-Pro和GLM-5.3-FlashX等一众国产模型。
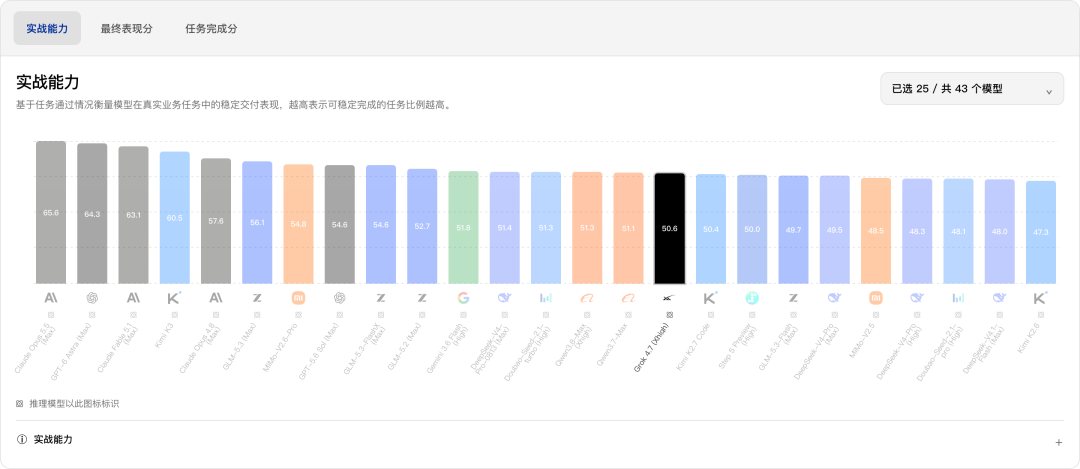
图1:SQBench官网截图。
更尴尬的是,排在它前面的几款国产模型,成本也更低。主打性价比,身边却站着一批更便宜、总分更高的对手。
01
Grok的性价比,国产模型不答应
官方对Grok 4.7的描述很直接:
“Twice as fast, at half the price of comparable models.”
也就是:相较同类模型,速度两倍,价格一半。发布页还用CursorBench 4.0的成绩与单任务费用曲线,强调其在长时间编程任务中的性价比。
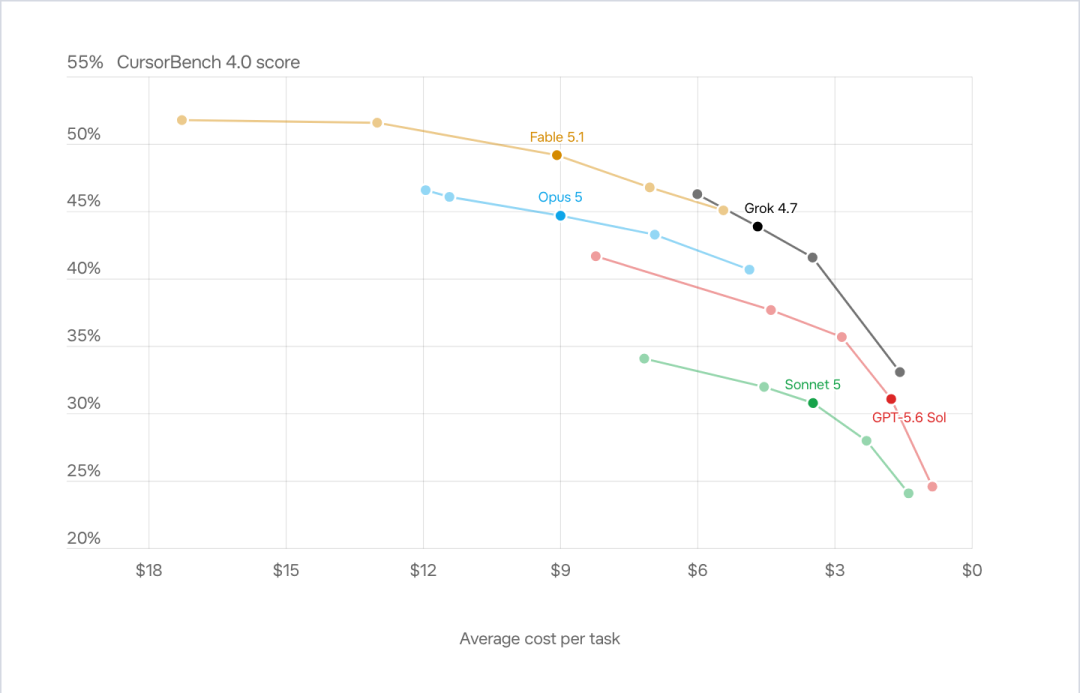
图2:Grok官方发布截图。横轴为平均单任务费用,从左向右降低;纵轴为CursorBench 4.0成绩。
Grok的便宜并非凭空而来。官方标准输入、输出报价分别为每百万Token 2美元和6美元,确实低于官方发布表中Sol的4美元和20美元,以及Fable 5.1的10美元和50美元。不过,“两倍速度、半价”的参照是同类竞品,不能理解为相对Grok 4.6再次提速、降价。
问题在于,这张官方性价比图里的对手,主要是Claude和GPT系列。而中国用户的选型清单里,还有DeepSeek、智谱、小米和月之暗面。把这些选择加进来,价格竞争的标准就变了。
先看SQBench同一套任务的结果:
模型/配置 | 实战能力得分 | 整轮评测费用 |
Grok 4.7(Xhigh) | 50.6 | $50.80 |
Kimi K3 | 60.5 | $42.17 |
GLM-5.3(Max) | 56.1 | $29.58 |
MiMo-V2.6-Pro | 54.8 | $4.45 |
GLM-5.3-FlashX(Max) | 54.6 | $5.68 |
DeepSeek-V4-Pro-0813(Max) | 51.4 | $9.83 |
GLM-5.3-Flash(Max) | 49.7 | $2.27 |
费用按各次评测的渠道、用量及价格快照核算,属于历史评测账单,并非用今天的统一价表重算。模型配置不同,结果用于比较各自已测配置下的能力与费用。
低预算的一端,国产模型已经把Grok的价格优势压了下去。MiMo-V2.6-Pro得分比它高4.2分,费用却只有它的约8.8%;GLM-5.3-FlashX高出4.0分,费用约为它的11.2%。花Grok约十分之一的钱,得到更高的综合成绩,这个差距已经很难用“我的Token单价不贵”解释过去。
DeepSeek-V4-Pro-0813也给出了类似选择:分数略高,整轮费用不到Grok的五分之一。即使继续压缩预算,GLM-5.3-Flash仍以2.27美元取得49.7分,距离Grok只有约0.9分。它没有在得分上超过Grok,却把取得接近表现所需的费用又拉低了一大截。
愿意多花一些预算,Grok同样很难突出。Kimi K3的评测费用比它低约17%,得分却高出9.9分;GLM-5.3则以约六成费用,取得56.1分。低价区间有MiMo、FlashX,较高预算区间有Kimi和GLM,Grok面临的是多个价格档位上的竞争。
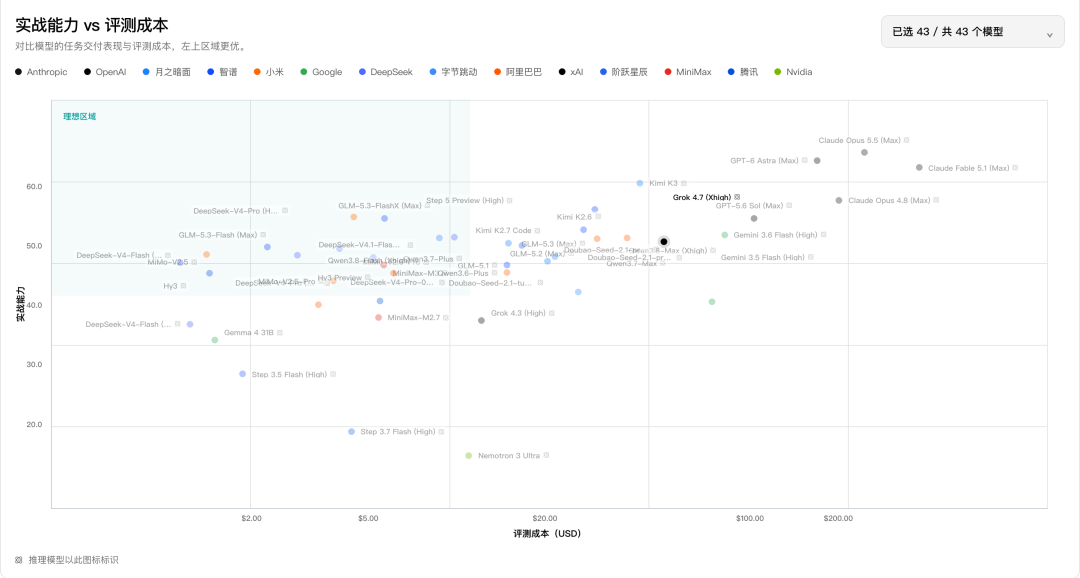
图3:SQBench官网截图。横轴为整轮评测费用,采用对数刻度,从左向右增加;纵轴为实战能力。
实际用量同样会影响账单。本轮Grok累计消耗约4177万Token,其中输入处理费用占总费用的62.3%。不同模型的输入、输出、缓存用量及对应价格,共同决定了最终账单。低单价能够降低每次调用的门槛,却不能单独保证做完一组工作更省钱。
02
代码逻辑登顶,综合实战却掉了队
Grok 4.7最突出的单项,是动态代码逻辑:25项任务全部通过。当前榜单中,Claude Opus 5.5、GPT-6 Astra、Claude Fable 5.1、Qwen3.8-Max和Grok 4.7共五个配置达到100%,Grok确实站在这一单项的第一梯队。
但这项成绩旁边,另外三个基础维度明显低了一截:指令遵循通过13/25,长文本推理11/25,鲁棒性与边界9/25,通过率分别为52%、44%和36%。四项合起来,原子能力层通过率为58%。
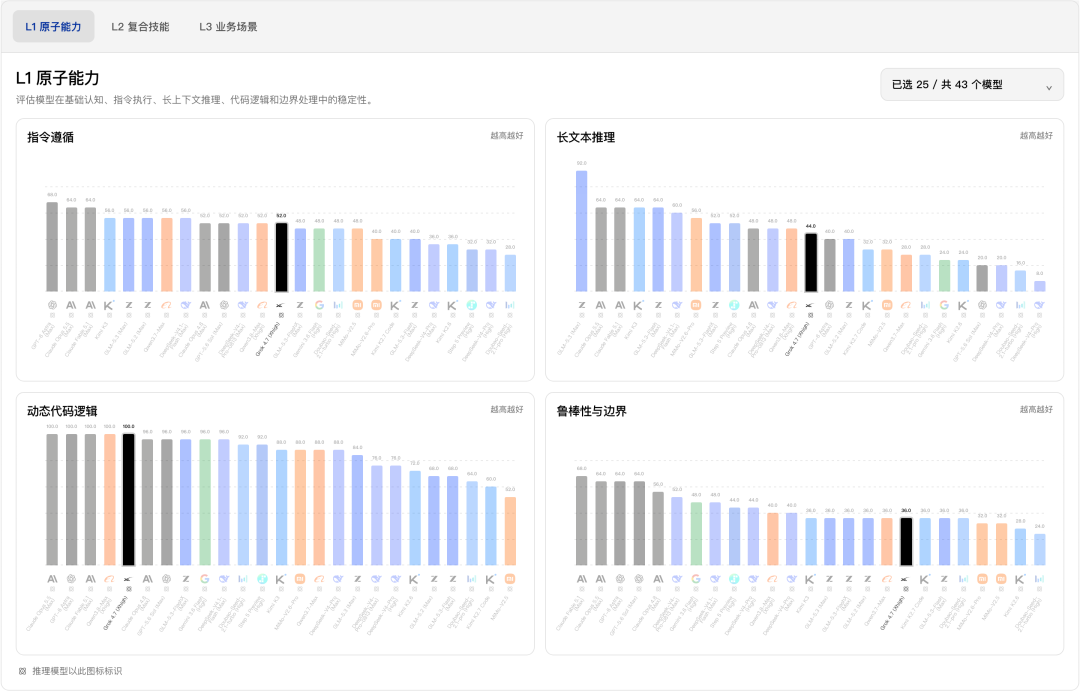
图4:SQBench官网截图。
真正拉开差距的,是从代码逻辑走向软件工程、再走向行业业务的过程。
在60项复合技能任务中,Grok通过35项,通过率58.3%。其中数据分析、深度研究、办公协作都是9/15,软件工程则为8/15,即53.3%。作为对照,GLM-5.3-FlashX的软件工程通过10/15,Kimi K3和Opus 5.5均为12/15,Astra为13/15。
能准确推导代码行为,与能交付一个工程任务,是两种要求。工程任务还需要模型定位问题、修改文件、验证结果,并交齐要求的文档和产物。Grok在这些环节上的表现,没有延续代码逻辑单项的领先。
一个推荐系统排障任务就很典型。少量超时集中发生在高活跃用户身上,导致点击率损失被放大。Grok找到了原因,并通过并行分片获取特征修复瓶颈,负载测试的回退率降到了0。但任务明确要求的审计报告没有生成,问题分析与修复依据没有按要求留下来;评分记录因此判定交付不完整,并触发可追溯性扣分,最终表现分为0.34。
难点解决了,任务却没有完整交付。这样的遗漏会把后续整理、核验和沟通工作重新留给人,也说明单项解题能力不能直接等同于工作完成能力。
行业任务的落差更大。Grok在60项行业业务任务中仅通过12项,通过率20%;金融、医疗各通过2/15,工业、政务各通过4/15。与之相比,Opus 5.5通过27项,Astra通过23项。面对多项规则、业务材料和交付要求,Grok距离领先模型仍有明显差距。
不过,也不必把这份成绩夸大成“其他能力全都不行”。Grok的办公协作通过率为60%,高于MiMo的53.3%和Kimi K3的46.7%;行业任务按完整达标统计通过率,未通过的任务也可能已经完成部分要求。更准确的评价是:它有突出强项,也有能完成的工作,但多项能力没有形成足够强的综合支撑。配上50.80美元的评测账单,这种不均衡就更难忽略。
回看SQBench最新评测数据,Claude Opus 5.5和GPT-6 Astra分别达到65.6分和64.3分。两者同样拥有满分的代码逻辑,并在软件工程和行业任务上交出更高的通过率,领先有更广的任务表现作为支撑。国产模型也在逼近:Kimi K3已到60.5分,距离两者分别为5.1分和3.8分;MiMo、FlashX则以更低费用提供了接近55分的表现。最高能力与低成本可用性,都在抬高竞争门槛。
这让Grok 4.7的位置变得尴尬:向上争夺复杂工作,要补齐综合交付;向下争夺预算敏感的用户,又要面对国产模型更低的实际账单。代码逻辑登顶值得肯定,但用户最终需要为一整项工作的结果付费。当更便宜的模型已经交出更高的综合成绩,“比昂贵的对手便宜”,就很难再成为足够有力的选择理由。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅