
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
今天凌晨,小米发布了MiMo-V2.6系列模型,SQBench紧随其后发布了MiMo-V2.6-Pro的实战能力评测结果,最终得分“54.8”,较前代MiMo-V2.5-Pro提高了10.8分,实战能力闯进国产模型TOP3。
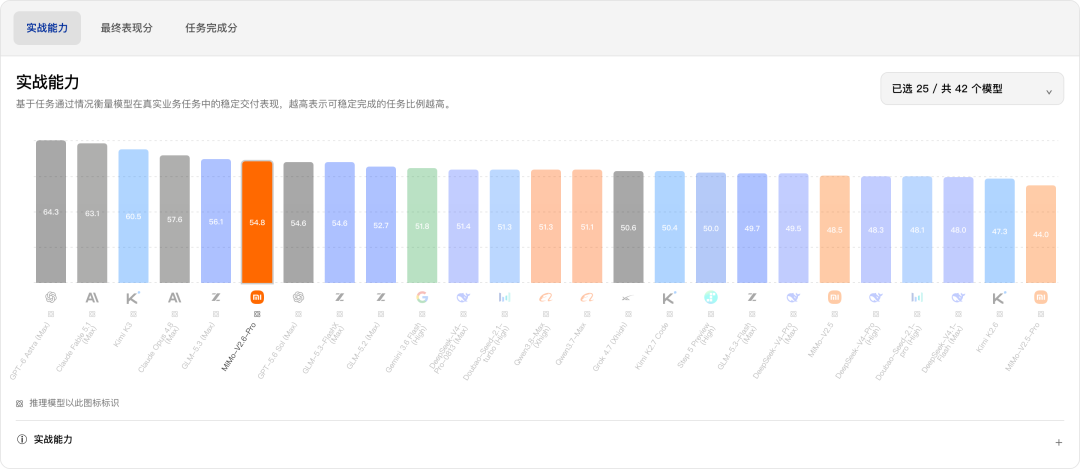
图1:SQBench实战能力榜单。数据截至2026年9月22日。
本轮评测中,MiMo-V2.6-Pro最突出的特点,是以较低费用取得了有竞争力的分析与执行表现。数据分析任务的通过任务数追平GLM-5.3,复合技能场景的通过率进入榜单前列。对于日常需要处理数据、核对材料、撰写分析报告的人,它是一款值得关注的“平价分析师”。
01
数据分析表现亮眼,能与GLM-5.3“扳手腕”
SQBench的数据分析任务要求模型读取文件或数据库,完成计算,并提交脚本、结果文件或分析报告。模型既要理解分析要求,也要实际处理数据,交付可检查的结果。
在这组15项任务中,MiMo-V2.6-Pro与GLM-5.3均通过12项,通过率为80%。逐项核对后,两者通过的是同样的12项任务。就这组工作的任务通过情况看,MiMo-V2.6-Pro已经能够与GLM-5.3正面比较。
电商漏斗分析是其中一个例子。任务要求从SQLite数据库提取浏览、加购和购买数据,覆盖未登录访客,找出流失环节,最后提交分析脚本、指标CSV和报告。
MiMo-V2.6-Pro使用cookie_id识别访客,将匿名流量纳入统计,得到以下结果:
漏斗阶段 | 去重访客数 | 较上一阶段流失率 |
浏览页面 | 1,782 | — |
加入购物车 | 1,715 | 3.76% |
完成购买 | 1,352 | 21.17% |
SQBench任务:据模型交付的原始CSV整理,列名和阶段名译为中文;首阶段不涉及环节流失率,以“—”表示。
这组结果将问题集中到了加购之后:从浏览到加购,访客流失率为3.76%;从加购到购买,流失率升至21.17%。运营人员可以据此优先排查结算环节,进一步判断支付、运费或其他因素是否影响购买。
统计口径也决定了这份分析能否使用。若只按登录账户计数,匿名用户可能被漏掉,整体转化情况就会失真。MiMo-V2.6-Pro按要求保留了这部分流量,提交的脚本和CSV又使报告中的数字可以被复核。同一项任务,GLM-5.3也通过了评测。
这类工作的成本往往花在提取、清洗、核对和反复改口径上。模型能够实际操作数据库,并留下脚本和结果文件,才有机会减少分析人员的准备工作。本次电商任务呈现的正是这种用途:先把数据处理和指标计算完成,让人有依据地继续排查业务问题。
两者完成这15项数据分析任务的费用,分别约为0.24美元和2.93美元。在通过任务数相同的情况下,MiMo-V2.6-Pro的费用约为GLM-5.3的8%。它在这组任务中表现出的竞争力,已经有了具体交付和费用记录的支撑。
02
价格低,紧跟DeepSeek的脚步
MiMo与DeepSeek的相似之处,主要体现在定价和开放策略上:在提升模型能力的同时,维持较低的API价格,并开放模型权重。MiMo-V2.6-Pro此次延续上一代定价,实战得分则明显提高,用户能够以相同的单价获得更强的模型能力。
低价API降低了日常调用的费用,开放权重则为自主部署和业务适配提供了选择。MiMo-V2.6-Pro-RL和DeepSeek-V4.1-Flash的官方模型仓库均标注MIT许可证,具备相应技术与算力条件的团队可以自行部署和改造模型。
API价格到底有多接近?按9月22日双方官网列示的人民币单价比较:
模型及计费时段 | 输入:缓存未命中 | 输出 | 输入:缓存命中 |
MiMo-V2.6-Pro | 3元 | 6元 | 0.025元 |
DeepSeek-V4.1-Flash:空闲时段 | 1元 | 4元 | 0.02元 |
DeepSeek-V4.1-Flash:高峰时段 | 2元 | 8元 | 0.04元 |
DeepSeek-V4-Pro-0813:空闲时段 | 4.5元 | 13.5元 | 0.15元 |
单位均为元/百万Token。
MiMo-V2.6-Pro的三项单价都低于DeepSeek-V4-Pro-0813的空闲时段价格。与V4.1-Flash相比,则处于相近的低价区间:MiMo的非缓存输入更贵,输出和缓存输入价格位于Flash峰谷价格之间。谁的账单更低,要看输入输出比例、缓存命中情况和调用时段。
SQBench的整轮评测,也体现了MiMo的费用优势。
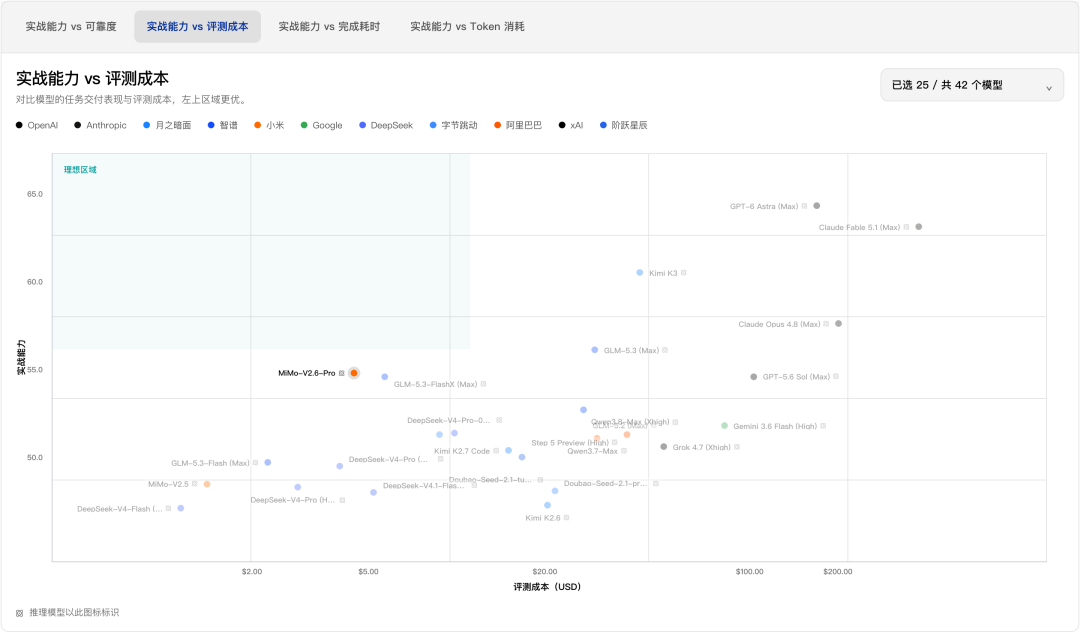
图2:SQBench实战能力与评测成本截图。
MiMo-V2.6-Pro的实战能力得分为54.8,GLM-5.3-FlashX为54.6;评测费用分别为4.45美元和5.68美元。两者得分接近,MiMo的费用低21.6%。从9月18日GLM-5.3-FlashX发布,到本轮MiMo评测,仅过四天,我们此前所说的“性价比之王”就有了新的竞争者。在当前SQBench高分模型的得分与费用比较中,MiMo-V2.6-Pro已接过这一称号。
速度优势仍在GLM-5.3-FlashX一侧,这里的评价针对实战得分与费用。
低价对分析工作的意义尤其直接。读取多份材料、执行脚本、检查结果,通常需要多轮模型调用。一次任务便宜下来之后,团队才更容易把这些能力用于日常报表、例行核对和批量分析,而不只是偶尔试用。开放权重则给有部署能力的团队留下了进一步适配自身业务的空间。
03
动手能力强,行业交付仍是共同难关
将范围扩展到全部60项复合技能场景,MiMo-V2.6-Pro通过39项,通过率为65%,在当前SQBench榜单中并列第五。它能够处理的工作已经覆盖数据分析、资料研究、办公协作和软件工程。
任务调度器修复就是一个实际执行的例子。模型需要解决依赖关系调度中的循环检测和大规模运行问题,同时保留优先级与遥测要求。MiMo-V2.6-Pro改用迭代式拓扑排序,完成代码修改,并执行测试。以下为工具运行记录中的连续节选:
OK: priority parsing & default-0 & topological constraintsOK: duplicate edgesOK: CircularDependencyError on self-cycle and 3-cycleOK: 25000-deep chain in 0.079sOK: 10k nodes / 30k edges in 0.040sOK: telemetry payload schema + per-job call
SQBench任务:模型修改代码后执行检查的原始输出节选,该任务通过评测。片段中的时间为被测程序运行时间。
但在60项行业业务场景中,MiMo-V2.6-Pro通过15项,通过率降至25%。将国内外其他模型放在一起看,这种差距相当普遍:
模型/配置 | 复合技能场景通过率 | 行业业务场景通过率 |
MiMo-V2.6-Pro | 65.0% | 25.0% |
GLM-5.3(Max) | 63.3% | 23.3% |
DeepSeek-V4-Pro-0813(Max) | 60.0% | 20.0% |
Kimi K3 | 71.7% | 26.7% |
GPT-6 Astra(Max) | 71.7% | 38.3% |
Claude Fable 5.1(Max) | 66.7% | 41.7% |
两层各包含60项不同任务。表中选取部分模型/配置;截至9月22日,SQBench已上线的模型/配置均呈现行业业务场景通过率低于复合技能场景的情况。
即使是本轮行业业务场景通过率最高的Claude Fable 5.1,也只通过25项,占41.7%。从完成通用分析和工具操作,到在金融、工业、医疗和政务任务中完整交付,目前各家模型都还有明显的距离。
大模型正在从对话辅助走向实际执行。SQBench中,复合技能场景与行业业务场景的通过率差距,也显示出从完成具体任务到完整业务交付之间仍有距离。数据分析、材料整理、代码修改,已经有了表现良好且费用较低的模型可用;涉及多环节协作、专业判断和业务责任的工作,则还需要更多人工参与。MiMo-V2.6-Pro的进步,让企业以更低费用引入这些能力成为可能。接下来值得期待的是,这些模型能在金融、工业、医疗等场景中稳定承担更多工作,让单项任务上的效率提升,逐步成为整个业务流程的实际收益。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅