
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
OpenAI也开始认真卷价格了。
9月22日,OpenAI发布GPT-6 Sol和GPT-6 Luna。两款模型采用与Astra相近的训练方法,主打更低的使用成本。Sol每百万Token的输入、输出价格分别为2美元、10美元;Luna更低,只需0.1美元、0.5美元。按照官方的说法,缓存和推理效率的改善,为这轮降价提供了条件。
官方公布的成绩也不错。在复杂软件工程测试DeepSWE v1.1中,Sol和Luna的Max配置分别取得68.8%和66.6%。在业务工作流测试AutomationBench中,Sol的xhigh配置取得33.2%,高于Astra的low配置30.3%,任务成本也更低。
沙丘社区也已完成两款模型的SQBench实战能力评测,成绩现已上线。GPT-6 Sol(Max)的SQBench得分为52.13%,GPT-6 Luna(Max)为43.73%。截至9月23日,二者分别位列45个已发布模型中的第11位和第34位。
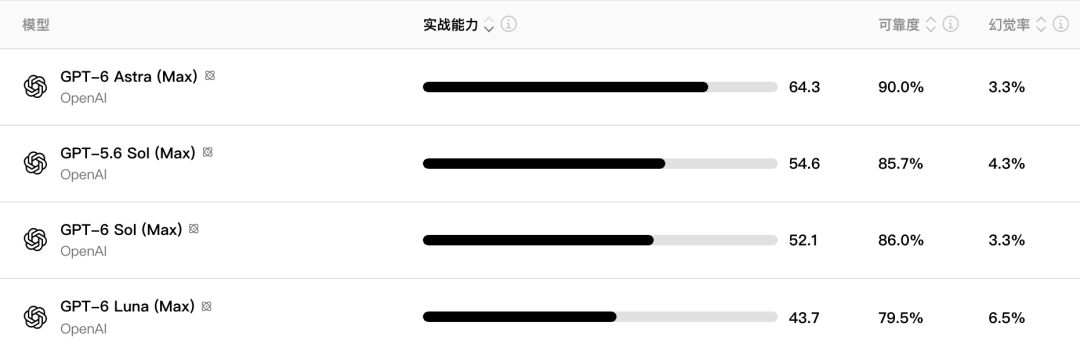
图1:SQBench官网截图,OpenAI近期发布的系列模型评测结果
价格确实降下来了,但Sol和Luna与Astra还差多少?面对已经很便宜的国产模型,它们又有多大胜算?
01
对比Astra:价格降下来了,能力到底行不行?
先把三款模型放在同一张表里。
SQBench指标 | GPT-6 Astra(Max) | GPT-6 Sol(Max) | GPT-6 Luna(Max) |
SQBench得分 | 64.27% | 52.13% | 43.73% |
L1原子能力通过数 | 68/100 | 59/100 | 52/100 |
L2复合技能通过数 | 43/60 | 35/60 | 29/60 |
L3业务场景通过数 | 23/60 | 16/60 | 13/60 |
三款均为Max配置,分项数字为通过任务数/任务总数。
Sol比Astra低12.14个百分点,Luna则低20.54个百分点。L1、L2、L3三个层级的通过数也都少于Astra,综合能力仍有差距。
分项来看,Sol的代码逻辑和办公协作表现较好,Luna的软件工程成绩也不错。
代码逻辑是最明显的一项。在L1动态代码逻辑的25项任务中,Sol与Astra均全部通过,Luna也通过23项,通过率达到92%。在这组测试中,Sol用更低的费用追平了Astra的成绩。
L2复合技能更接近实际工作,四个分项的结果如下。
L2复合技能 | Astra(Max) | Sol(Max) | Luna(Max) |
数据分析 | 12/15 | 8/15 | 7/15 |
软件工程 | 13/15 | 10/15 | 11/15 |
深度研究 | 8/15 | 6/15 | 3/15 |
办公协作 | 10/15 | 11/15 | 8/15 |
Sol在办公协作中通过11项,比Astra多1项;Luna在软件工程中通过11项,比Sol多1项。虽然只差一道题,还不足以判断谁能稳定领先,但这也说明,便宜的模型并非每一项都弱。如果工作主要集中在这些任务上,可以先测试低价模型能否胜任,再决定是否需要为旗舰多花钱。
Astra在数据分析和深度研究上仍然领先。尤其是Luna,软件工程通过了11项,深度研究却只通过3项。同一款模型,在不同任务上的表现可以相差很大,不能根据代码成绩判断它是否适合做研究。
长文本推理的成绩更低:Astra通过10/25,Sol为4/25,Luna为5/25。三款模型在这项测试上都还有不足。上下文窗口再长,模型也可能漏掉材料中的关键条件,或无法正确关联分散的证据。
L3行业业务任务也拉开了差距。60项任务中,Astra通过23项,Sol为16项,Luna为13项。其中,Sol的金融任务仅通过1/15;Luna的15项工业任务均未完整通过,虽然完成了部分要求,但还没有达到通过标准。
从这些结果看,Sol和Luna可以作为部分日常任务的低价选择,但用于复杂研究和行业业务时,还需要逐项验证。省下调用费之后,如果又增加了大量人工检查和返工,就未必划算。
与上一代相比,新Sol也没有在本轮测试中取得更高的总分。GPT-5.6 Sol(Max)的成绩为54.60%,新Sol为52.13%,但整轮费用比旧记录低约65.5%。单轮测试还不能据此判断新模型全面退步,不过,这次Sol最明显的改善是费用下降,综合成绩并未提高。
02
OpenAI加入价格战,能打过千问、DeepSeek和智谱吗?
与Astra相比,两款模型便宜了很多。Sol的输入、输出单价均比Astra低80%,Luna则均低99%。
在SQBench的完整测试中,Sol和Luna的费用分别比Astra低约79.0%和98.4%。对于已经使用OpenAI模型的团队,如果日常任务用Sol或Luna就能完成,调用费用便有大幅下降的空间。
不过,判断性价比,还得和同样便宜的国产模型比一比。
Sol比千问略占优势,但还有更便宜、得分更高的国产模型。
模型配置 | SQBench得分 | 评测费用相较Sol |
GPT-6 Sol(Max) | 52.13% | 比较基准 |
Qwen3.8-Max(Xhigh) | 51.33% | 高约7.4% |
GLM-5.3(Max) | 56.06% | 低约16.8% |
DeepSeek-V4-Pro-0813(Max) | 51.40% | 低约72.3% |
GLM-5.3-FlashX(Max) | 54.60% | 低约84.0% |
Sol比Qwen3.8-Max高0.80个百分点,整轮费用也略低。在这两个已测配置之间,Sol确实做到了分数更高、费用更低。
但与智谱的模型相比,Sol就没有这种优势了。GLM-5.3得分更高、费用更低;FlashX同样得分更高,而Sol的评测费用是它的约6.3倍。DeepSeek-V4-Pro-0813虽然比Sol低0.73个百分点,费用却不到Sol的三成。
所以,Sol能给千问带来竞争压力,但还谈不上在性价比上领先这些国产对手。
Luna已经很便宜,但国产模型还能做到费用更低、得分更高。
模型配置 | SQBench得分 | 评测费用相较Luna |
GPT-6 Luna(Max) | 43.73% | 比较基准 |
Qwen3.8-Flash(Xhigh) | 40.00% | 高约23.3% |
GLM-5.3-Flash(Max) | 49.73% | 低约17.4% |
DeepSeek-V4-Flash(High) | 47.07% | 低约58.2% |
DeepSeek-V4-Flash(Max) | 36.80% | 低约55.2% |
以上两表均为SQBench已发布配置的测试记录,保留各自推理档位;它们反映具体配置的实测结果,不代表各模型的全部可选档位。费用比较分别以Sol、Luna为基准,按各次运行的记录计算,并非按今天的价格重新计费。
Luna的得分和费用同样优于Qwen3.8-Flash,但GLM-5.3-Flash和DeepSeek-V4-Flash的High配置都比Luna得分高。费用上,Luna分别是这两款配置的约1.2倍和2.4倍。这里也列出了DeepSeek-V4-Flash的Max成绩:它反而低于High配置。这说明,实际选型时还要比较推理档位,不能默认开到最高档就能得到更好的结果。
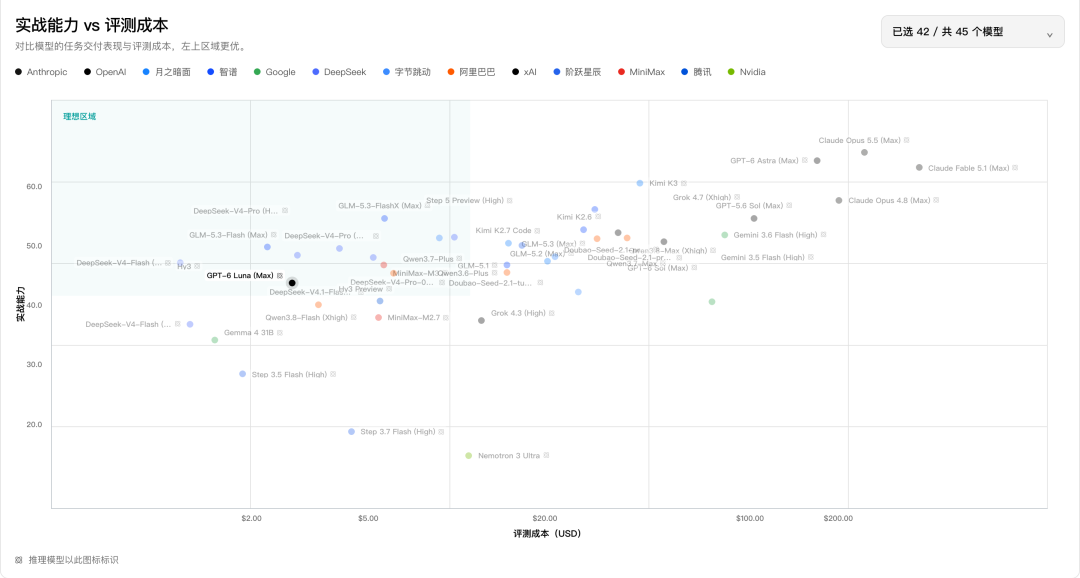
图2:SQBench官网截图。
从本轮测试看,Sol和Luna都能与国产模型比较性价比了。其中,千问面临直接压力;智谱和DeepSeek则仍各有优势。OpenAI的降价增加了选择,国产模型的费用优势也仍然存在。
企业还需要关注模型在完成任务时到底用了多少Token。
这次Luna消耗约3071万Token,比Sol的约2294万多33.9%,最后的费用却低得多。因此,比较费用时,既要看Token单价,也要看消耗量和缓存使用情况。实际业务还会产生重试、人工验收和返工成本,只有把这些算在一起,才能判断换用便宜模型究竟省了多少钱。
Astra、Sol和Luna正好呈现了这种分工:Astra的综合成绩更高,Sol和Luna以较低费用完成其中一部分工作。国产模型也在争夺这些日常调用需求。OpenAI这次降价后,国产厂商需要继续提高同等预算下的任务表现,OpenAI也得证明自己的低价模型足够好用。
同等能力越来越便宜,已经是大模型市场的持续变化。这轮价格竞争对用户最直接的好处,是日常工作有了更多便宜的模型可选。选模型时,最终要比较的是完成同一项工作需要花多少钱、返工多少次。Sol和Luna已经有资格参与这场竞争,但从SQBench的评测结果看,国产模型仍然很能打。
更多AI研究内容可前往【沙丘智库小程序】搜索查阅