
作者|沙丘智库研究团队
来源|沙丘社区(www.shaqiu.cn)
国产模型近期密集更新,阶跃星辰这次能往前挤几个位置?
9月20日,阶跃星辰发布了Step 5 Preview。我们实测的High推理强度在SQBench上拿到50.00分,比此前Step 3.7 Flash(High)的18.73分高出31.27分,超过了旧版DeepSeek V4 Pro(Max)的49.53分,也略高于GLM-5.3-Flash(Max)的49.73分。
但再往榜单上面看,8月更新的DeepSeek V4 Pro 0813(Max)已经拿到51.40分,刚发布的GLM-5.3-FlashX(Max)则是54.60分。阶跃星辰这次进步很大,已经接近国内主流模型的得分区间。只是它往前赶的时候,竞争对手也在更新。
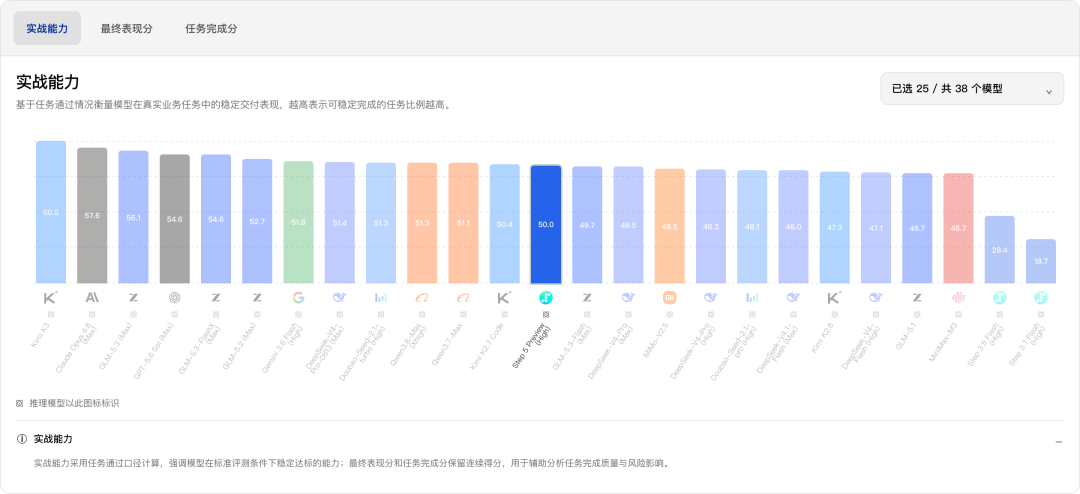
图:SQBench实战能力排名。
随着模型能力差距缩小,用户对模型的关注点也发生了变化:同样的工作,Step 5 Preview能不能做得更好、更快、更便宜?
我们让它完成SQBench的220项实战能力任务,累计耗时25.2小时。评测结论是:Step 5 Preview已经接近国内主流模型的实战水平,但在得分接近的对手面前,它的费用和耗时并没有优势。
01
巨大提升
首先来看Step 5 Preview相较于前代模型的提升。
SQBench 220项实战能力任务中,Step 3.7 Flash通过43项任务,Step 3.5 Flash通过50项任务,而Step 5 Preview是102项。
数据分析是变化最明显的一类。 15项任务中,Step 3.7 Flash没有一项完全通过,Step 5 Preview通过了11项。
其中一项工作,是帮营销负责人找到最值得挽留的客户。预算有限,不能给所有老客户发一遍优惠券;数据库里的金额和日期格式又不统一,得先把账算清楚,才谈得上怎么花钱。
Step 5 Preview处理了7,991行订单数据,为50家客户计算最近购买时间、订单频次和利润贡献,交付了Python脚本、客户明细CSV和分析报告。这项任务,Step 3.7 Flash得分为0,Step 5 Preview拿到了满分。
报告里有一个细节值得看。所有客户最近一个月都买过东西,如果只按“多久没有下单”设置一个统一阈值,很容易觉得客户还算稳定。Step 5 Preview进一步比较了客户各自的购买节奏,指出排名第二的客户OUR Ltd,过去约每4天购买一次,现在已经14天没有下单,应当优先关注。
下面是它交付报告中的原文片段:
The #2 account in the company is quietly slipping.OUR Ltd ($168,264) placed only 2 orders in December 2020 against its own 4-day buying cadence — it is the largest true churn exposure in the file, and it is invisible if you rank customers by value alone.
节选自本次任务交付文件rfm_insights.md;金额指评测数据中的历史利润贡献。
对营销负责人来说,这份报告已经给出了下一通电话该打给谁、为什么要打。OUR Ltd有没有流失,需要联系后确认;至少,有限的跟进资源有了明确去处。
代码修复也有明显进步。 15项软件工程任务,Step 3.7 Flash通过6项,Step 5 Preview通过10项。
我们选了一道内存泄漏题。任务提供了一个模拟大模型推理引擎的内存块分配器:多个序列共享内存,序列结束后,部分内存却没有被正确释放,运行下去就会耗尽资源。模型需要修改代码,补上验证脚本,并解释问题根因。
Step 5 Preview检查了共享内存的引用计数,在创建分支时增加引用,在释放序列时减少引用,最后一个使用者释放后才回收内存。它写入的回收逻辑如下:
for logical_idx in sorted(seq.logical_to_physical.keys()):
block = seq.logical_to_physical[logical_idx]
block.ref_count -= 1
if block.ref_count <= 0:
block.ref_count = 0
self.allocated_blocks.pop(block.block_id, None)
if block not in self.free_blocks:
self.free_blocks.append(block)
节选自本次任务实际修改的block_manager.py,仅去除片段整体缩进。
它还检查了另一个容易遗漏的路径:请求的序列不存在时,不能先拿走内存块,再报错退出,否则仍会留下泄漏。随后,模型运行验证脚本,检查内存块是否全部归还,以及是否仍有孤立块或泄漏。
实际测试输出是:
PASS: 100/100 blocks recovered | 0 orphan blocks | 0 leaks
=== FUZZ TEST ===
FUZZ_SCORE: 1.0
后续3,000轮压力测试中,内存池也保持完整。Step 3.7 Flash在这道题上得分为0,Step 5 Preview完全通过。
对开发者来说,这个结果比“解释得很有道理”更有分量:代码改了,异常路径补了,测试也跑出了结果。客户分析和内存修复,正好说明这次进步最扎实的两个方向。
02
慢半拍
如果只和自家旧模型比较,Step 5 Preview这次足以交出一份亮眼的成绩单。但用户面对的,是整个市场已经能用到的模型。
尤其值得放在一起看的,是DeepSeek V4 Pro 0813、GLM-5.3-FlashX,以及Doubao-Seed-2.1-Turbo(High)。三者在SQBench上的得分都高于Step 5 Preview,完成同一套任务的费用和累计耗时也都更低。
模型 | 实战能力得分 | 评测费用 | 累计耗时 |
Step 5 Preview | 50.00 | 16.72美元 | 25.20小时 |
DeepSeek V4 Pro 0813 | 51.40 | 9.83美元 | 12.12小时 |
GLM-5.3-FlashX | 54.60 | 5.68美元 | 6.67小时 |
Doubao-Seed-2.1-Turbo | 51.33 | 8.74美元 | 14.68小时 |
费用为本轮实际API消耗记录,耗时为各任务累计用时,包含模型响应和工具执行。
DeepSeek V4 Pro 0813是最直接的参照。 两者只差1.4分,但Step 5 Preview花了约1.7倍费用、2.1倍时间。即便只取两者都完全通过的83项任务,Step 5 Preview的累计耗时仍约为DeepSeek V4 Pro 0813的2.3倍。
GLM-5.3-FlashX带来的压力更大。 Step 5 Preview用接近三倍的费用、接近四倍的累计耗时,得到的综合分数仍低4.6分。阶跃星辰刚刚越过GLM-5.3-Flash,GLM-5.3-FlashX已经用更短的时间交出了更高的成绩。
Doubao-Seed-2.1-Turbo则说明,竞争也不完全按版本发布时间排队。这款已经在榜上的模型,得分高于Step 5 Preview,费用接近其一半,累计耗时也少了十个多小时。阶跃星辰要面对的对手,既有刚更新的模型,也有这些仍然保持竞争力的老型号。
再看具体工作,Step 5 Preview并没有处处落后。
完全通过任务数 | Step 5 Preview | DeepSeek V4 Pro 0813 | GLM-5.3-FlashX | Doubao-Seed-2.1-Turbo |
数据分析/15 | 11 | 10 | 11 | 10 |
软件工程/15 | 10 | 9 | 10 | 10 |
深度研究/15 | 7 | 9 | 10 | 9 |
办公协作/15 | 7 | 8 | 8 | 9 |
行业业务场景/60 | 12 | 12 | 12 | 13 |
数据分析和软件工程,它已经能与这几款模型竞争。拉开差距的是另外一些工作:搜集资料后能否交出完整研究,处理办公任务时能否把要求逐一落实。Step 5 Preview在25项指令遵循测试中只通过8项,DeepSeek V4 Pro 0813为13项,GLM-5.3-FlashX和Doubao-Seed-2.1-Turbo均为12项。
一项房地产研究任务就暴露了这种落差。Step 5 Preview做了不少检索,最终却没有交付要求的报告。准备过程再充分,接收任务的人也只能按“报告没交”处理。官方此次强调长程执行和专业工作,能否在这些任务中持续、完整地交付,仍是我们会继续观察的地方。
行业业务场景中,Step 5 Preview、DeepSeek V4 Pro 0813和GLM-5.3-FlashX虽然都完全通过了12项任务,整体完成质量仍有差距。按全部60项任务的最终表现计算平均分,三者分别为71.70%、83.36%和81.35%。完全通过的数量相同,整体得分仍是后两者更高。
当然,Step 5 Preview也有比对手便宜的比较对象:Qwen3.8-Max(Xhigh)本轮费用38.18美元,Kimi K3为42.17美元,都明显高于它。阶跃星辰并非没有成本优势,只是面对DeepSeek V4 Pro 0813、GLM-5.3-FlashX和Doubao-Seed-2.1-Turbo这几款模型,优势还立不住。
从这次实测看,Step 5 Preview已经进入国内主流模型的竞争行列。数据分析和代码修复有了拿得出手的表现,50分也已经接近DeepSeek V4 Pro 0813、Qwen3.8-Max所在的区间。不过,Kimi K3的60.54分、GLM-5.3(Max)的56.06分仍在前面,现在就把它列入国内领跑阵营,还早了些。
“慢半拍”,说的是这次发布面对的竞争。在这批任务里,得分略高的几款对手,费用和累计耗时都更低。
Step 5 Preview已经明显缩小了差距。下一次,我们期待看到阶跃星辰从追赶走向领先!
更多AI研究内容可前往【沙丘智库小程序】搜索查阅