


研究方法论
本页汇集沙丘智库各研究内容所采用的方法论,帮助你了解研究结论的形成方式、适用范围和阅读重点。
场景分析方法
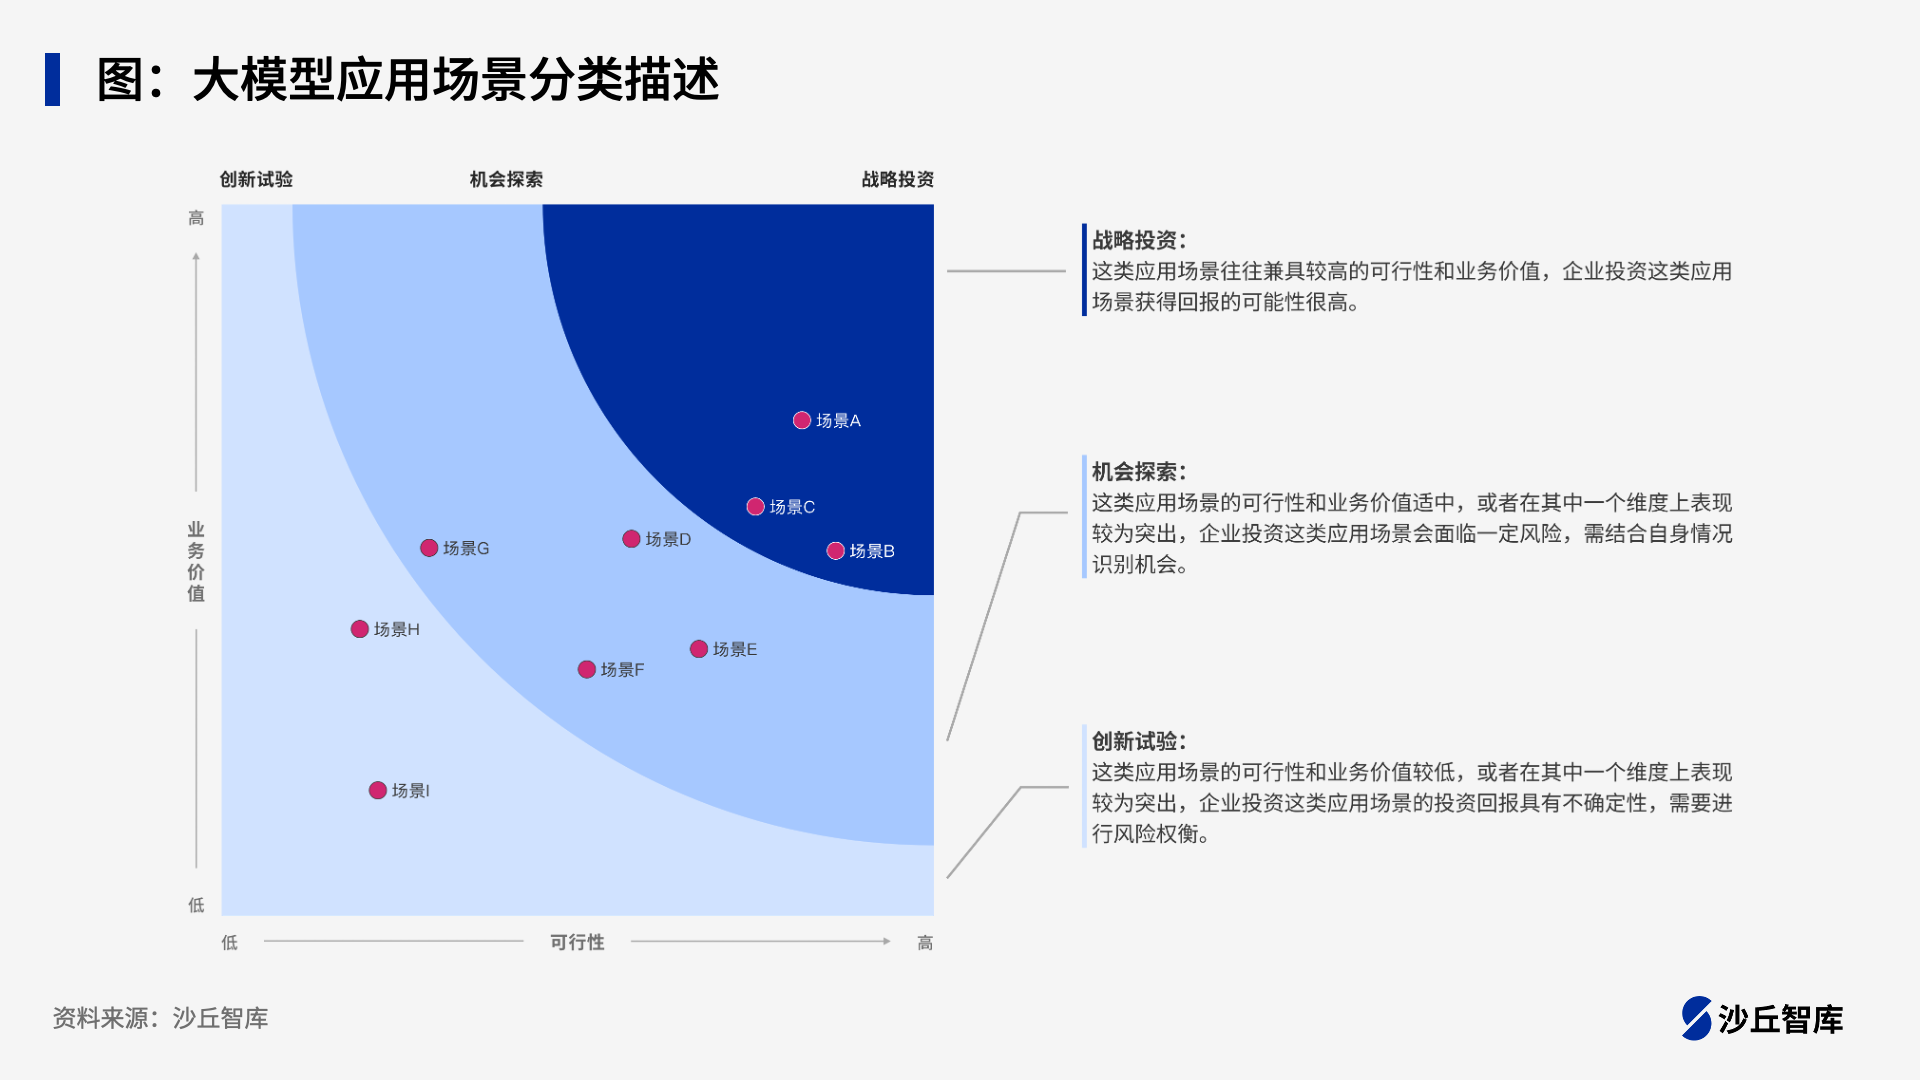
沙丘智库从业务价值和可行性两个维度分析大模型应用场景,并将场景划分为战略投资、机会探索、创新试验三类。
| 场景类型 | 判断依据 | 使用建议 |
|---|---|---|
| 战略投资 | 兼具较高可行性和业务价值 | 企业投入后获得回报的可能性较高,可优先纳入重点规划。 |
| 机会探索 | 可行性和业务价值处于中等水平,或其中一个维度表现突出 | 企业可结合自身情况识别机会,并通过进一步调研或小范围试用验证价值。 |
| 创新试验 | 可行性和业务价值较低,或仅其中一个维度表现突出 | 投资回报存在较大不确定性,应在明确风险承受范围后开展探索。 |
企业应结合自身的技术成熟度、资源投入能力、风险承受能力和数字化转型目标,判断适合优先推进的应用场景。
模型评估方法
沙丘智库以真实工作中常见的任务形式评估大模型的任务交付能力、可靠性和资源使用情况,帮助用户理解不同模型在相同条件下的相对表现,为模型初筛和试点设计提供参考。
评测使用 SQBench v1.0 的 220 道标准化任务。所有模型在相同任务版本、输入材料、工具环境、资源限制和评分规则下完成单次全量测试;测试任务经过脱敏、改写或合成处理,不包含真实客户数据或个人敏感信息。
评估范围
| 任务层级 | 重点关注 | 任务数 | 综合权重 |
|---|---|---|---|
| 基础能力层(L1) | 指令理解、长上下文、代码逻辑和鲁棒性等基础能力 | 100 | 20% |
| 复合技能层(L2) | 办公协作、深度研究、数据分析和软件工程等多步骤任务 | 60 | 60% |
| 业务场景层(L3) | 金融、工业、医疗、政务等业务流程中的端到端任务 | 60 | 20% |
主要观察维度
| 维度 | 说明 | 报告中的对应内容 |
|---|---|---|
| 任务交付能力 | 模型是否能完成任务要求,并提交可用结果 | 实战能力、任务完成分、最终表现分,以及分层能力分析 |
| 可靠性与风险 | 模型在完成任务时是否出现事实错误、遗漏约束、越权、不可复核等可核验问题 | 可靠度、风险触发率、幻觉率和 10D 风险矩阵 |
| 资源使用 | 模型完成本次完整测试所消耗的成本、时间和 Token | 成本与运行情况、性价比分析 |
其中,实战能力反映模型在各层任务中达到完整交付要求的比例,并按 L1 20%、L2 60%、L3 20% 加权;任务完成分反映未扣除风险前的功能完成度;最终表现分则反映纳入风险后的可交付水平。两者之间的差距可以帮助判断模型是否存在“能完成、但仍需较多检查”的情况。
可靠度表示本次测试中未触发已确认风险的任务比例。风险识别覆盖事实与溯源、指令遵循、合规与安全、资源使用、工具操作、任务完成、可解释性和上下文管理等十类问题。资源指标不参与能力评分,用于辅助比较不同模型的使用成本和运行效率。
如何阅读评测报告
建议先阅读执行摘要,了解模型的总体表现、适用方向和主要限制;再结合分层能力分析、风险类型和典型案例,判断模型是否适合具体任务。性价比分析中的四张图分别比较实战能力与可靠度、评测成本、完成耗时和 Token 消耗:每张图只说明一个维度上的相对位置,不能合成为单一的“性价比”结论。
评测结果描述的是当前任务集、模型版本、推理配置和运行条件下的表现,不代表模型在所有业务场景中的绝对能力,也不替代企业在自身数据、流程、权限和合规要求下的验证。对于高风险或关键流程,建议在试点中增加人工复核、结果校验、权限控制和异常回退机制。